

 快速开始
 集成 / SDK
 用户验证
 企业验证
 交易监控
 更新日志
活体检测方法
我们的平台实现了三种各具特色的反欺骗技术,分别针对不同的安全需求和用户体验进行了量身定制:| 方法 | 描述 | 安全级别 | 适用场景 |
|---|---|---|---|
3D Action & Flash | • 将多因子生物识别验证与随机动作序列及动态光线图案分析相结合。 • 开始时,系统会提示用户执行一个简单的动作(如眨眼或点头),以确保实时交互。 • 与此同时,系统会将一系列光线图案投射到面部,分析反光以确认面部的三维结构。 • 深度学习算法会检查微表情和光线反射响应,从而验证活人的存在。 • 通过融合行为(动作)和物理(基于光线的深度)线索提供最高级别安全性,使得静态图像、视频甚至高级面具几乎无法实施欺骗攻击。 | 最高 | 银行、医疗、政务应用 |
3D Flash | • 使用动态光线图案分析来验证面部拓扑结构,无需用户交互。 • 以超过每秒 30 帧的速率向面部投射一系列光线图案,并通过分析反射来创建深度图。 • 该深度图可确认面部的三维结构,将其与平面图像或 2D 欺骗区分开来。 • 在抵御照片或屏幕等呈现攻击的同时,提供无缝顺畅的体验并保持高安全性。 | 高 | 金融服务、账户访问、身份验证 |
Passive Liveness | • 依靠单帧深度学习分析来检测活体迹象。 • 检查图像是否存在伪影、纹理图案以及其他区分真实人脸与欺骗攻击的细微特征。 • 卷积神经网络(CNN)可验证面部特征并识别异常情况,例如来自打印照片或数字屏幕的异常。 • 提供快速便捷的验证,但提供的是标准安全性,适用于低风险用例。 | 标准 | 低摩擦场景、消费级应用 |
3D Flash 和 3D Action & Flash 的高级安全性:
- 这些方法旨在抵御复杂的欺骗攻击,例如高品质面具、深度伪造和视频重放。
- 通过投射动态光线图案并分析其反射,它们能够检测光线与真实的 3D 人脸交互时与平面或人造表面的差异。
- 3D Action & Flash 方法通过随机动作(例如眨眼或点头)增加了一层额外的安全保障,需要预录媒体或合成身份无法复现的实时行为响应。
- 经证实,这些方法可提供高准确率和低的错误接受率,是高风险环境的理想选择。
可配置阈值
您可以通过为活体评分设置不同的阈值来自定义安全级别。例如: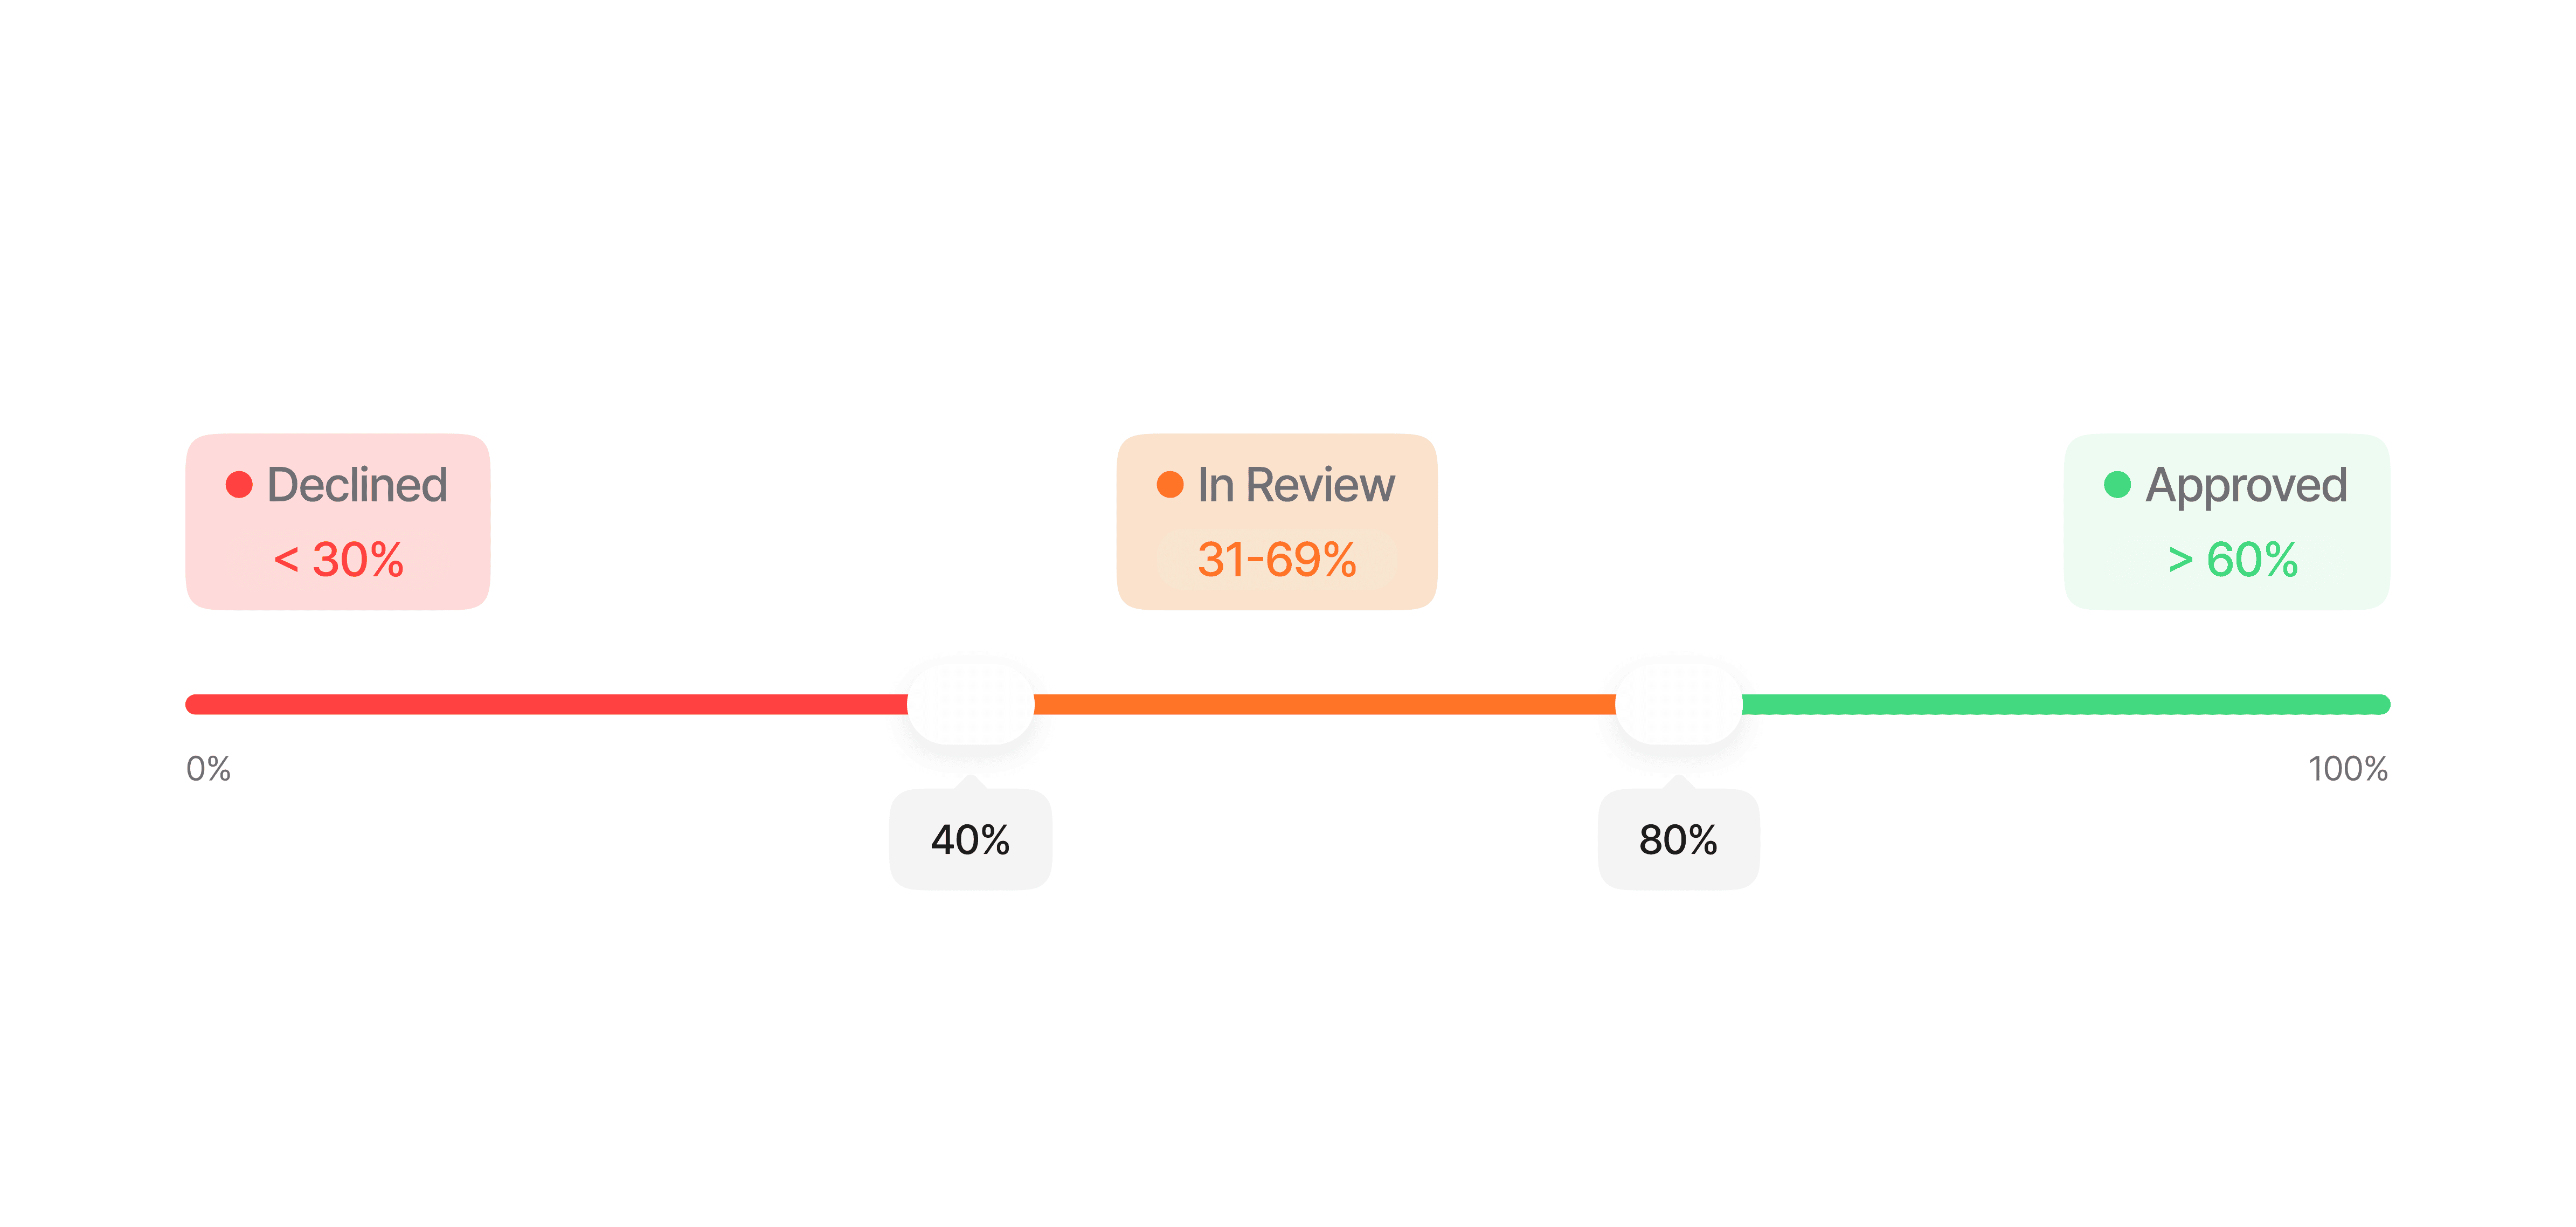
这些阈值可以根据您的风险承受能力和安全要求进行调整,为各种用例提供灵活性。
重试与可操作反馈
在 Didit 会话中,因可修复原因(光线不佳、人脸未居中、遮挡、临界分数)而失败的活体采集不会立即被拒绝。系统会提示用户根据具体指引重试,最多可达到配置的尝试次数。-
尝试次数配额 —
face_liveness_max_attempts控制每次会话的活体提交总次数。默认为 3(一次初始尝试加两次重试),可按工作流节点配置(范围 1–3)。 -
重试反馈 — 在仍有尝试次数时,可重试的失败将使用户停留在活体检测步骤,并返回包含可操作
feedback_codes的响应体(Web 和移动端 SDK 会自动将这些代码呈现为引导提示信息): -
可重试代码 —
LOW_FACE_LUMINANCE(过暗)、HIGH_FACE_LUMINANCE(过亮)、NO_FACE_DETECTED、LOW_FACE_QUALITY、HIGH_FACE_OCCLUSION、LOW_LIVENESS_SCORE、MULTIPLE_FACES_DETECTED、AGE_NOT_DETECTED。 -
采集环境保证重试 —
LOW_FACE_LUMINANCE、HIGH_FACE_LUMINANCE、LOW_FACE_QUALITY、HIGH_FACE_OCCLUSION和NO_FACE_DETECTED描述的是用户所处的房间环境,而非用户本人。当尝试仅因这些代码失败时,即使用户所在工作流配置了face_liveness_max_attempts: 1,用户也始终能获得第二次尝试机会以及上述引导提示信息。所有其他代码仍严格遵循配置的配额。 -
配额耗尽与欺诈 — 一旦配额耗尽,将应用计算出的状态(
Declined或In Review)。确认的呈现攻击(LIVENESS_FACE_ATTACK)、命中黑名单以及重复人脸将立即拒绝,绝不允许重试。
重试仅适用于会话流程。独立的
POST /v3/passive-liveness/ endpoint 是无状态且仅支持单次调用的 — 它直接返回结果,没有重试配额。工作原理
视频自拍采集
系统通过针对所选活体检测方法定制的简单、直观的界面引导用户完成操作。
活体检测分析
先进算法实时处理采集到的媒体,以检测欺骗攻击。不同方法的分析方式有所不同:
多层检测可识别包括照片、屏幕、面具和深度伪造在内的呈现攻击。
3D Action & Flash
3D Action & Flash
- 验证用户的动作(例如眨眼或点头),以确认动作执行正确且为真人实时操作
- 分析光照图案反射以验证人脸的三维结构
- 利用深度学习评估微表情及其他行为线索
- 结合行为与物理信号,实现最强的防欺骗性能
3D Flash
3D Flash
- 以 30+ FPS 的帧率处理一系列光照图案反射,构建详细的深度图
- 确认人脸的 3D 特征,将其与平面或 2D 欺骗区分开来
- 无需用户交互 — 从用户角度来看完全是被动的
Passive Liveness
Passive Liveness
- 对单帧图像应用深度学习,检测纹理图案和伪影
- 卷积神经网络(CNN)验证面部特征并识别异常
- 最快的方法 — 仅需单张照片采集即可运行
结果处理与核验
系统将活体检测分数与您配置的阈值进行比对,并立即返回结果。
结果通过 API 响应、Webhook 交付,或可在业务控制台中查看,并附带用于合规的详细审计日志。