

 Primeros pasos
 Integración / SDKs
 Verificación de usuarios
 Verificación de empresas
 Monitorización de transacciones
 Registro de cambios
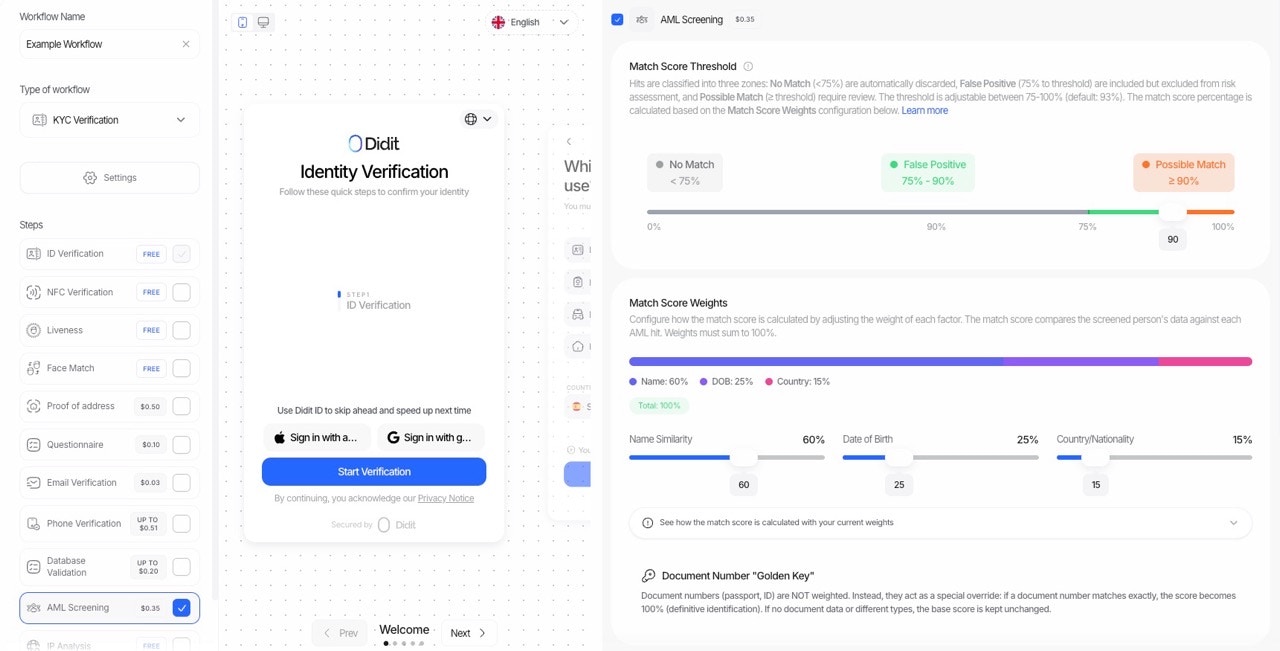
⚠️ Importante: La Puntuación de coincidencia determina la clasificación de cada coincidencia, NO el estado AML final. El estado AML final (Aprobado/En revisión/Rechazado) lo determina la puntuación de riesgo de las coincidencias que no son falsos positivos.
Descripción general
Al evaluar a una persona frente a listas de vigilancia AML, cada posible coincidencia recibe una puntuación de coincidencia de 0 a 100. Esta puntuación responde a la pregunta: “¿Esta coincidencia es realmente la misma persona que estamos analizando?”Puntuación de coincidencia frente a puntuación de riesgo
Cómo la puntuación de coincidencia determina el estado de revisión
Cada coincidencia se clasifica según su puntuación de coincidencia:Umbral predeterminado: 93%Ejemplo: Con un umbral de 93:
- Coincidencia con puntuación 85 → Falso positivo (descartada automáticamente)
- Coincidencia con puntuación 95 → Sin revisar (requiere revisión; la puntuación de riesgo determina la urgencia)
Explicación de los estados de revisión
Todas las coincidencias AML comienzan con uno de dos estados iniciales según su puntuación de coincidencia:
Tras la revisión manual, los responsables de cumplimiento pueden cambiar el estado a:
Consejo: Puedes cambiar el estado de revisión de una coincidencia en la Console desde la vista general de AML o haciendo clic en una coincidencia concreta para ver sus detalles.
Cómo se calcula la puntuación de coincidencia
Paso 1: Cálculo de la puntuación base
La puntuación base se calcula con tres componentes de pesos configurables:Nota: Los pesos deben sumar siempre 100%.
Paso 2: Lógica de “llave maestra” (Golden Key) del número de documento
Después de calcular la puntuación base, el número de documento se evalúa por separado con una lógica especial de reemplazo:
Este enfoque reconoce que un número de documento coincidente es una prueba definitiva de identidad (la “llave maestra”), mientras que los tipos de documento distintos no deben penalizar la puntuación.
Detalles de la puntuación por componente
Similitud del nombre (0-100)
La comparación de nombres usa el algoritmo WRatio de RapidFuzz, que tolera:- Erratas y errores ortográficos
- Diferencias en el orden de las palabras (“John Smith” frente a “Smith, John”)
- Variaciones del segundo nombre (“Robert J. Smith” frente a “Robert James Smith”)
- Diferencias de longitud
Puntuación de la fecha de nacimiento
Importante: cuando la coincidencia solo ofrece un año (p. ej., “1974”), que ese año coincida cuenta como una coincidencia completa, porque es toda la información disponible para verificar.
Puntuación de país/nacionalidad
El sistema convierte automáticamente entre:
- Códigos ISO alfa-2 (ES)
- Códigos ISO alfa-3 (ESP)
- Nombres completos de país (Spain)
countries, también comprueba el campo citizenship.
Normalización de la puntuación (reponderación)
Cuando faltan datos de la persona analizada o de la coincidencia, el sistema aplica la normalización de la puntuación para no penalizar por información que no está disponible.Ejemplo: análisis solo con el nombre
Si haces el análisis solo con un nombre (sin fecha de nacimiento ni país):
Resultado: la puntuación del nombre constituye la totalidad de la puntuación de coincidencia.
Ejemplo: falta el país en la coincidencia
Si la coincidencia no tiene datos de país, pero sí fecha de nacimiento:
Esto garantiza una puntuación justa independientemente de los datos disponibles.
Opciones de configuración
Puedes personalizar el cálculo de la puntuación de coincidencia mediante la API o la configuración del flujo de verificación (workflow):Umbral de puntuación de coincidencia
Pesos (deben sumar 100)
Ejemplo de solicitud a la API
Respuesta: desglose de la puntuación
Cada coincidencia de la respuesta incluye:match_score: la puntuación de coincidencia calculada (0-100)risk_score: la puntuación de riesgo calculada (0-100); consulta Puntuación de riesgoreview_status: “False Positive” o “Unreviewed”, según el umbral de puntuación de coincidenciascore_breakdown: desglose detallado del cálculo de la puntuación de coincidencia
Flujo completo: de la puntuación de coincidencia al estado AML final
Ejemplos de cálculo
Ejemplo 1: Coincidencia fuerte → Sin revisar
Datos analizados:- Nombre: “Robert J. Smith”
- Fecha de nacimiento: “1985-03-15”
- País: “US”
- Nombre: “Robert James Smith”
- Fecha de nacimiento: “1985”
- País: “United States”
- Puntuación de nombre: 90% (coincidencia aproximada)
- Puntuación de fecha de nacimiento: 100% (la coincidencia solo tiene el año, y el año coincide)
- Puntuación de país: 100% (coincidencia exacta)
Ejemplo 2: Coincidencia débil → Falso positivo
Datos analizados:- Nombre: “John Smith”
- Fecha de nacimiento: “1990-05-20”
- País: “US”
- Nombre: “Johnny Smithson”
- Fecha de nacimiento: “1975”
- País: “Canada”
- Puntuación de nombre: 72% (coincidencia aproximada débil)
- Puntuación de fecha de nacimiento: -100% (penalización por discrepancia de año)
- Puntuación de país: -50% (penalización por discrepancia de país)
Ejemplo 3: Anulación por Golden Key
Datos analizados:- Nombre: “John D. Smith”
- Número de documento: “A12345678”
- Nombre: “Jonathan David Smith”
- Número de documento: “A12345678”
- Puntuación base: ~70 (coincidencia aproximada del nombre)
- Número de documento: COINCIDE (coincidencia exacta)
Gestionar el estado de revisión
Tras la clasificación inicial, puedes actualizar manualmente el estado de revisión de cada coincidencia:En la consola
- Ve al resumen AML de la sesión
- Haz clic en una coincidencia concreta para ver los detalles
- Usa el desplegable de estado para cambiar el estado de revisión:
- Coincidencia confirmada: verifica que se trata de la misma persona
- Falso positivo: marca que la coincidencia no corresponde
- No concluyente: no es posible determinarlo
Buenas prácticas
- Empieza con el umbral predeterminado (93): ofrece un buen equilibrio entre detectar coincidencias reales y filtrar falsos positivos.
- Baja el umbral en escenarios de alto riesgo: si necesitas ser más cauteloso, baja el umbral de puntuación de coincidencia para detectar más coincidencias potenciales.
- Usa números de documento cuando estén disponibles: ofrecen la confirmación de identidad más sólida y pueden anular puntuaciones de coincidencia bajas.
- Revisa los pesos normalizados: consulta los campos de peso normalizado en el desglose de la puntuación para entender cómo afectaron los datos faltantes a la puntuación.
- Supervisa las tasas de falsos positivos: si se están marcando demasiadas coincidencias legítimas como falsos positivos, baja el umbral.