

 Primeros pasos
 Integración / SDKs
 Verificación de usuarios
 Verificación de empresas
 Monitorización de transacciones
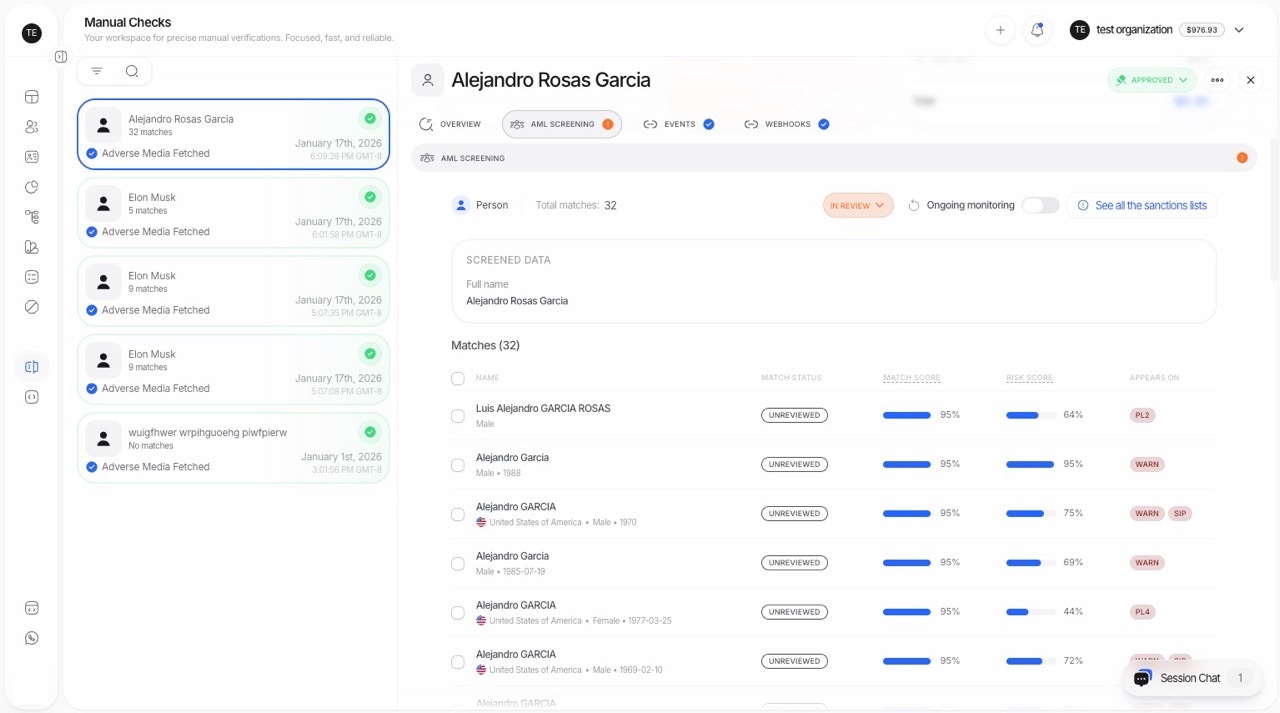
Conceptos clave: puntuación de coincidencia frente a puntuación de riesgo
Didit usa un sistema de dos puntuaciones para el análisis AML:Puntuación de coincidencia (confianza de identidad)
- Pregunta: ¿esta coincidencia es la misma persona que estamos analizando?
- Factores: similitud del nombre, fecha de nacimiento, país o nacionalidad, número de documento
- Finalidad: clasifica la coincidencia como falso positivo o sin revisar (posible coincidencia)
- Umbral: umbral de puntuación de coincidencia (por defecto: 93)
Puntuación de riesgo (nivel de riesgo de la entidad)
- Pregunta: ¿qué nivel de riesgo tiene esta entidad si la coincidencia es real?
- Factores: riesgo del país, categoría (PEP, sanciones, etc.), antecedentes penales
- Finalidad: determina el estado AML final (aprobado, en revisión o rechazado)
- Umbrales: umbral de aprobación (por defecto: 80) y umbral de revisión (por defecto: 100)
Estados de revisión de coincidencias
A cada coincidencia AML se le asigna un estado de revisión según su puntuación de coincidencia:Consejo: puedes cambiar el estado de revisión de una coincidencia en la Consola, desde la visión general de AML o haciendo clic en una coincidencia concreta para ver sus detalles.
Funciones principales
1. Extracción de datos completa
- Extracción precisa: extrae datos de la información que aporta el usuario o de documentos de identidad con tecnología OCR avanzada.
- Lógica difusa: tiene en cuenta variaciones y errores ortográficos en los nombres para capturar los datos de forma completa.
2. Amplia cobertura de listas de vigilancia
Analiza varias categorías, entre ellas:- Listas de sanciones: de organismos gubernamentales e internacionales.
- Personas expuestas políticamente (PEP): personas con funciones públicas destacadas.
- Antecedentes penales: incluidas bases de datos penales globales y locales.
- Menciones en noticias negativas: artículos y reportes sobre delitos financieros y otros riesgos.
- Listas de vigilancia personalizadas: configurables según los requisitos específicos de cada cliente.
3. Algoritmos de coincidencia avanzados
- Coincidencia difusa: detecta pequeñas variaciones en nombres o datos para lograr una coincidencia precisa.
- Varios datos de contraste: usa nombre, fecha de nacimiento, nacionalidad y otros identificadores para un análisis exhaustivo.
- Lógica de Golden Key: la coincidencia del número de documento puede imponerse a las puntuaciones para una identificación definitiva.
4. Evaluación de riesgo con dos puntuaciones
Cada coincidencia recibe DOS puntuaciones:
Estado de revisión de la coincidencia (según la puntuación de coincidencia):
- Falso positivo: puntuación de coincidencia por debajo del umbral; es probable que NO sea la misma persona
- Sin revisar: puntuación de coincidencia igual o superior al umbral; requiere revisión
- Aprobado: todas las coincidencias sin revisar tienen puntuaciones de riesgo bajas
- En revisión: al menos una coincidencia sin revisar tiene una puntuación de riesgo media-alta
- Rechazado: al menos una coincidencia sin revisar tiene una puntuación de riesgo muy alta
5. Análisis detallado de noticias negativas
Analiza una amplia gama de categorías de noticias negativas, entre ellas:- Delitos financieros: blanqueo de capitales, malversación y más.
- Delitos violentos: agresión, homicidio y delitos relacionados.
- Terrorismo: participación en actividades terroristas o apoyo a ellas.
- Narcóticos: tráfico de drogas y delitos relacionados.
- Fraude: distintos tipos de fraude y prácticas engañosas.
- Infracciones regulatorias: incumplimientos de requisitos normativos.
6. Parámetros de análisis personalizables
- Sensibilidad ajustable: configura la sensibilidad del análisis según la tolerancia al riesgo de tu organización.
- Listas de vigilancia personalizables: elige qué listas y categorías incluir en el análisis para cumplir requisitos específicos.
Umbrales configurables
Puedes personalizar los niveles de seguridad con distintos umbrales: Configuración de la puntuación de coincidencia:
Umbrales de la puntuación de riesgo (estado final):
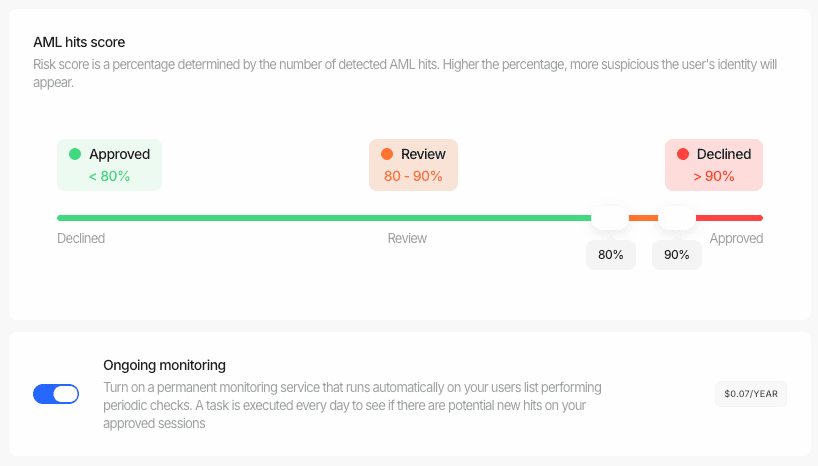
Estos umbrales se pueden ajustar según tu tolerancia al riesgo y tus requisitos de seguridad.
Cómo funciona
Nuestro proceso de análisis AML identifica con eficiencia los posibles riesgos y minimiza los retrasos para los usuarios legítimos.Extracción de datos
El sistema extrae la información relevante de los datos aportados por el usuario o de los documentos de identidad subidos.
Análisis en listas de vigilancia
Los datos extraídos se contrastan en tiempo real con más de 1,300+ listas de vigilancia y bases de datos globales:
- Listas de sanciones: organismos gubernamentales e internacionales (OFAC, UE, ONU, etc.)
- Personas expuestas políticamente (PEP): personas con funciones públicas destacadas
- Antecedentes penales: bases de datos penales globales y locales
- Noticias negativas: artículos y reportes sobre delitos financieros
- Listas de vigilancia personalizadas: configurables según tus requisitos
Cálculo de la puntuación de coincidencia
Para cada posible coincidencia, el sistema calcula una puntuación de confianza de identidad: la probabilidad de que sea la misma persona.
- Puntuación de coincidencia por debajo del umbral (por defecto: 93) → se clasifica como falso positivo
- Puntuación de coincidencia igual o superior al umbral → se clasifica como sin revisar (posible coincidencia)
- Golden Key: la coincidencia del número de documento puede elevarla al 100% para una identificación definitiva
Cálculo de la puntuación de riesgo
Para las coincidencias que no son falsos positivos, el sistema calcula el nivel de riesgo de la entidad:
Determinación del estado final
Según la puntuación de riesgo más alta entre todas las coincidencias que no son falsos positivos:
Si todas las coincidencias son falsos positivos, el resultado es aprobado (no se encontraron coincidencias creíbles).
Generación del resultado
Se genera un informe detallado con total transparencia:
- La puntuación de coincidencia y la puntuación de riesgo de cada coincidencia, con su desglose
- La clasificación de la coincidencia (falso positivo, sin revisar o confirmada)
- La base de datos de origen y los detalles de categoría de cada resultado
- Resultados entregados por respuesta de la API, webhook o Business Console
- Decisión automática según los umbrales de puntuación de riesgo que configures
Referencia de datos de un resultado AML
Cada resultado AML devuelto en la respuesta de la API contiene información detallada sobre la entidad coincidente. A continuación se describen los campos clave y sus posibles valores.Categorías de conjuntos de datos
El campodatasets de cada resultado indica en qué categorías de bases de datos de cumplimiento se encontró la entidad. Valores posibles:
Coincidencias de sanciones
El arreglosanction_matches contiene los detalles de cada lista de sanciones en la que se encontró la entidad. Campos clave:
Coincidencias de advertencias
El arreglowarning_matches contiene los detalles de las coincidencias de listas de advertencias, sanciones regulatorias y similares. El campo additional_data puede incluir un arreglo data.case_details con información estructurada del caso.
Tipos de caso de advertencia
El campocase_type dentro de additional_data.data.case_details[] describe la naturaleza del caso de advertencia. Valores conocidos: