

 Commencer
 Intégrer / SDK
 Vérification des utilisateurs
 Vérification d'entreprise
 Surveillance des transactions
 Journal des modifications
Méthodes de détection du vivant
Notre plateforme met en œuvre trois technologies anti-usurpation distinctes, chacune adaptée à des besoins de sécurité et des parcours utilisateur différents :| Méthode | Description | Niveau de sécurité | Idéal pour |
|---|---|---|---|
3D Action & Flash | • Combine une vérification biométrique multifactorielle avec une séquence d’actions aléatoires et une analyse dynamique des motifs lumineux. • Au début, l’utilisateur est invité à effectuer une action simple (comme cligner des yeux ou hocher la tête), garantissant une interaction en temps réel. • Simultanément, le système projette une séquence de motifs lumineux sur le visage, analysant les reflets pour confirmer la structure tridimensionnelle du visage. • Des algorithmes d’apprentissage profond examinent les micro-expressions et les réponses aux reflets lumineux pour vérifier la présence d’une personne vivante. • Offre la sécurité la plus élevée en intégrant des indices comportementaux (action) et physiques (profondeur basée sur la lumière), rendant toute usurpation quasi impossible avec des images statiques, des vidéos ou même des masques perfectionnés. | Le plus élevé | Secteur bancaire, secteur de la santé, applications gouvernementales |
3D Flash | • Utilise l’analyse dynamique des motifs lumineux pour valider la topologie faciale sans nécessiter d’interaction de la part de l’utilisateur. • Projette une série de motifs lumineux sur le visage à plus de 30 images par seconde, en analysant les reflets pour générer une carte de profondeur. • Cette carte de profondeur confirme la structure tridimensionnelle du visage, le distinguant des images plates ou des usurpations en 2D. • Offre une expérience fluide tout en maintenant une haute sécurité contre les attaques par présentation telles que les photos ou les écrans. | Élevé | Services financiers, accès aux comptes, vérification d’identité |
Passive Liveness | • Repose sur l’analyse d’apprentissage profond d’une seule image pour détecter les signes de présence du vivant. • Examine l’image à la recherche d’artefacts, de motifs de texture et d’autres indicateurs subtils différenciant un vrai visage d’une usurpation. • Un réseau de neurones convolutif (CNN) valide les caractéristiques faciales et identifie les anomalies, telles que celles provenant de photos imprimées ou d’écrans numériques. • Offre une vérification rapide et pratique, mais propose une sécurité standard, adaptée aux cas d’usage à faible risque. | Standard | Scénarios à faible friction, applications grand public |
Sécurité avancée de 3D Flash et 3D Action & Flash :
- Ces méthodes sont conçues pour déjouer les attaques par usurpation sophistiquées, telles que les masques de haute qualité, les deepfakes et les rediffusions vidéo.
- En projetant des motifs lumineux dynamiques et en analysant leurs reflets, elles détectent la manière dont la lumière interagit avec un vrai visage en 3D par rapport à une surface plane ou artificielle.
- La méthode 3D Action & Flash ajoute un niveau de sécurité supplémentaire grâce à une action aléatoire (par exemple, cligner des yeux ou hocher la tête), exigeant des réponses comportementales en temps réel que des supports préenregistrés ou des identités synthétiques ne peuvent pas reproduire.
- Reconnues pour offrir une haute précision et de faibles taux de fausse acceptation, ces méthodes sont idéales pour les environnements à forts enjeux.
Seuils configurables
Vous pouvez personnaliser les niveaux de sécurité en définissant différents seuils pour les scores de vivacité. Par exemple :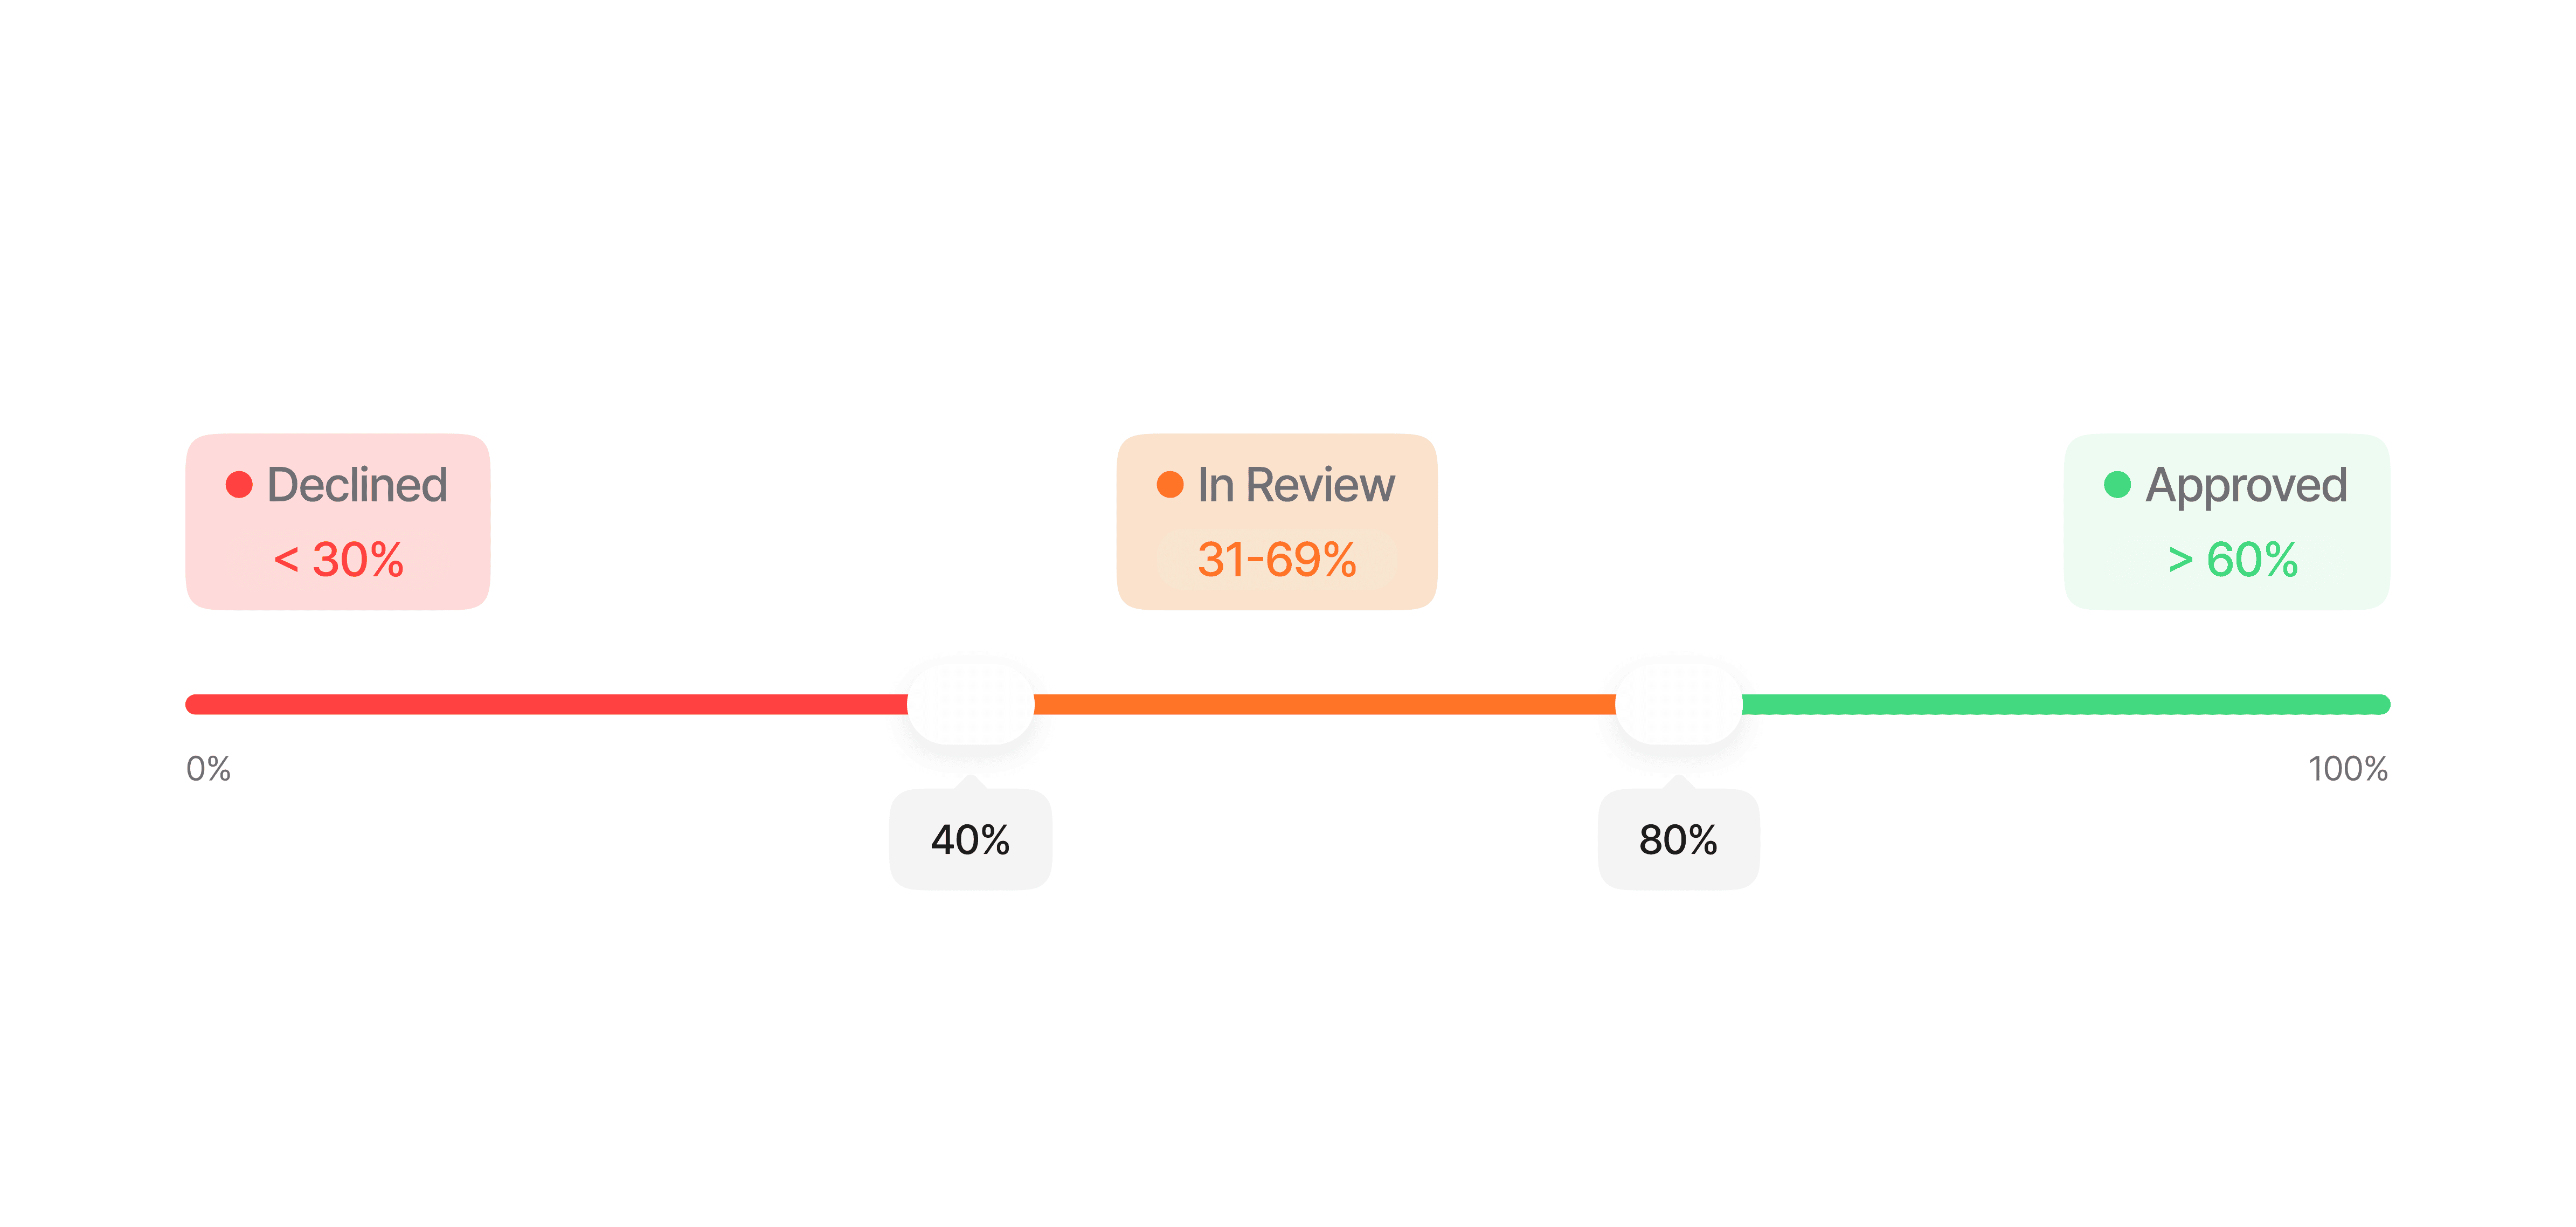
Ces seuils peuvent être ajustés en fonction de votre tolérance au risque et de vos exigences de sécurité, offrant une grande souplesse selon les cas d’usage.
Réessais et retours exploitables
Dans une session Didit, une capture de détection du vivant qui échoue pour une raison résoluble (mauvais éclairage, visage non centré, obstruction, score limite) n’entraîne pas un refus immédiat. L’utilisateur est invité à réessayer avec des conseils précis, jusqu’à un nombre configurable de tentatives.-
Budget de tentatives —
face_liveness_max_attemptscontrôle le nombre total de soumissions de détection du vivant par session. Par défaut 3 (une tentative initiale plus deux réessais), configurable par nœud de workflow (plage de 1 à 3). -
Retour d’information lors d’un réessai — tant qu’il reste des tentatives, un échec permettant un réessai maintient l’utilisateur à l’étape de détection du vivant et renvoie un corps contenant des
feedback_codesexploitables (les SDK Web et Mobile affichent automatiquement ces messages de guidage) : -
Codes permettant un réessai —
LOW_FACE_LUMINANCE(trop sombre),HIGH_FACE_LUMINANCE(trop lumineux),NO_FACE_DETECTED,LOW_FACE_QUALITY,HIGH_FACE_OCCLUSION,LOW_LIVENESS_SCORE,MULTIPLE_FACES_DETECTED,AGE_NOT_DETECTED. -
Réessai garanti pour les conditions de capture —
LOW_FACE_LUMINANCE,HIGH_FACE_LUMINANCE,LOW_FACE_QUALITY,HIGH_FACE_OCCLUSIONetNO_FACE_DETECTEDdécrivent la pièce dans laquelle se trouve l’utilisateur, et non la personne elle-même. Lorsqu’une tentative échoue uniquement en raison de ces codes, l’utilisateur bénéficie systématiquement d’une deuxième tentative avec le message de guidage ci-dessus, même sur un workflow configuré avecface_liveness_max_attempts: 1. Tous les autres codes respectent toujours exactement le budget configuré. -
Épuisement et fraude — une fois le budget épuisé, le statut calculé est appliqué (
DeclinedouIn Review). Les attaques par présentation confirmées (LIVENESS_FACE_ATTACK), les correspondances dans la liste de blocage et les visages dupliqués entraînent immédiatement un refus et ne font jamais l’objet d’un réessai.
Les réessais s’appliquent uniquement au flux de session. L’endpoint autonome
POST /v3/passive-liveness/ est sans état et à usage unique — il renvoie le résultat directement sans budget de réessai.Comment ça fonctionne
Capture de selfie vidéo
L’utilisateur est guidé à travers une interface simple et intuitive, adaptée à la méthode de détection du vivant sélectionnée.
Analyse de la détection du vivant
Des algorithmes avancés traitent les médias capturés en temps réel pour détecter les tentatives d’usurpation. L’analyse diffère selon la méthode :
Une détection multicouche identifie les attaques par présentation, notamment les photos, les écrans, les masques et les deepfakes.
3D Action & Flash
3D Action & Flash
- Vérifie l’action de l’utilisateur (par exemple, clignement d’yeux ou hochement de tête) pour confirmer qu’elle est exécutée correctement et en direct
- Analyse les reflets de motifs lumineux pour valider la structure tridimensionnelle du visage
- Utilise l’apprentissage profond pour évaluer les micro-expressions et d’autres signaux comportementaux
- Combine signaux comportementaux et physiques pour offrir la meilleure résistance aux usurpations
3D Flash
3D Flash
- Traite une séquence de reflets de motifs lumineux à 30+ FPS pour créer une carte de profondeur détaillée
- Confirme les propriétés 3D du visage, le distinguant ainsi des usurpations plates ou en 2D
- Aucune interaction requise de la part de l’utilisateur — entièrement passive du point de vue de l’utilisateur
Passive Liveness
Passive Liveness
- Applique l’apprentissage profond à une seule image pour détecter les motifs de texture et les artefacts
- Un réseau de neurones convolutif (CNN) valide les caractéristiques faciales et identifie les anomalies
- Méthode la plus rapide — fonctionne avec une seule capture photo
Traitement des résultats et vérification
Le système compare le score de détection du vivant à vos seuils configurés et fournit les résultats instantanément.
Les résultats sont transmis via une réponse API, un webhook, ou consultables dans la Console Business avec des journaux d’audit détaillés pour la conformité.