

 시작하기
 연동 / SDK
 사용자 인증
 기업 확인
 거래 모니터링
 변경 내역
라이브니스 감지 방법
당사 플랫폼은 서로 다른 보안 요구와 사용자 경험에 맞춘 세 가지 스푸핑 방지 기술을 구현합니다.| 방식 | 설명 | 보안 수준 | 적합한 용도 |
|---|---|---|---|
3D Action & Flash | • 다중 요소 생체 인증을 무작위 동작 시퀀스와 동적 빛 패턴 분석과 결합합니다. • 시작 시 사용자에게 눈 깜빡임이나 고개 끄덕임 같은 간단한 동작을 요청하여 실시간 상호작용을 보장합니다. • 동시에 시스템은 얼굴에 빛 패턴 시퀀스를 투사하고, 반사광을 분석하여 얼굴의 입체 구조를 확인합니다. • 딥러닝 알고리즘이 미세 표정과 빛 반사 반응을 분석하여 실제 사람이 있는지 확인합니다. • 행동(동작) 신호와 물리적(빛 기반 깊이) 신호를 함께 사용하여 가장 높은 보안을 제공하며, 정지 이미지, 동영상, 고급 마스크로도 스푸핑하기가 사실상 불가능합니다. | 최고 | 금융, 의료, 공공 기관 애플리케이션 |
3D Flash | • 사용자 상호작용 없이 동적 빛 패턴 분석을 사용하여 얼굴 형태를 검증합니다. • 초당 30 프레임 이상으로 얼굴에 일련의 빛 패턴을 투사하고, 반사광을 분석하여 깊이 맵을 생성합니다. • 이 깊이 맵은 얼굴의 입체 구조를 확인하여 평면 이미지나 2D 스푸프와 구별합니다. • 사진이나 화면 같은 프레젠테이션 공격에 대해 높은 보안을 유지하면서 끊김 없는 경험을 제공합니다. | 높음 | 금융 서비스, 계정 접근, 신원 확인 |
Passive Liveness | • 단일 프레임 딥러닝 분석에 의존하여 라이브니스 징후를 감지합니다. • 이미지에서 아티팩트, 텍스처 패턴, 그리고 실제 얼굴과 스푸프를 구별하는 기타 미세한 지표를 살펴봅니다. • 합성곱 신경망(CNN)이 얼굴 특징을 검증하고, 인쇄 사진이나 디지털 화면에서 나온 것과 같은 이상 징후를 식별합니다. • 빠르고 편리한 검증을 제공하지만 표준 보안 수준이므로 위험도가 낮은 사용 사례에 적합합니다. | 표준 | 사용자 불편이 적은 시나리오, 소비자 애플리케이션 |
3D Flash 및 3D Action & Flash의 고급 보안:
- 이 방식들은 고품질 마스크, 딥페이크, 동영상 재생 같은 정교한 스푸핑 공격을 막도록 설계되었습니다.
- 동적 빛 패턴을 투사하고 그 반사광을 분석하여, 빛이 실제 3D 얼굴과 평평하거나 인위적인 표면에서 어떻게 상호작용하는지 감지합니다.
- 3D Action & Flash 방식은 무작위 동작(예: 눈 깜빡임 또는 고개 끄덕임)으로 추가 보안 계층을 더하며, 사전 녹화된 미디어나 합성 신원이 복제할 수 없는 실시간 행동 반응을 요구합니다.
- 높은 정확도와 낮은 오인 수락률을 입증하였으며, 이 방식들은 중요도가 높은 환경에 적합합니다.
구성 가능한 임계값
라이브니스 점수에 서로 다른 임계값을 설정하여 보안 수준을 조정할 수 있습니다. 예를 들면 다음과 같습니다.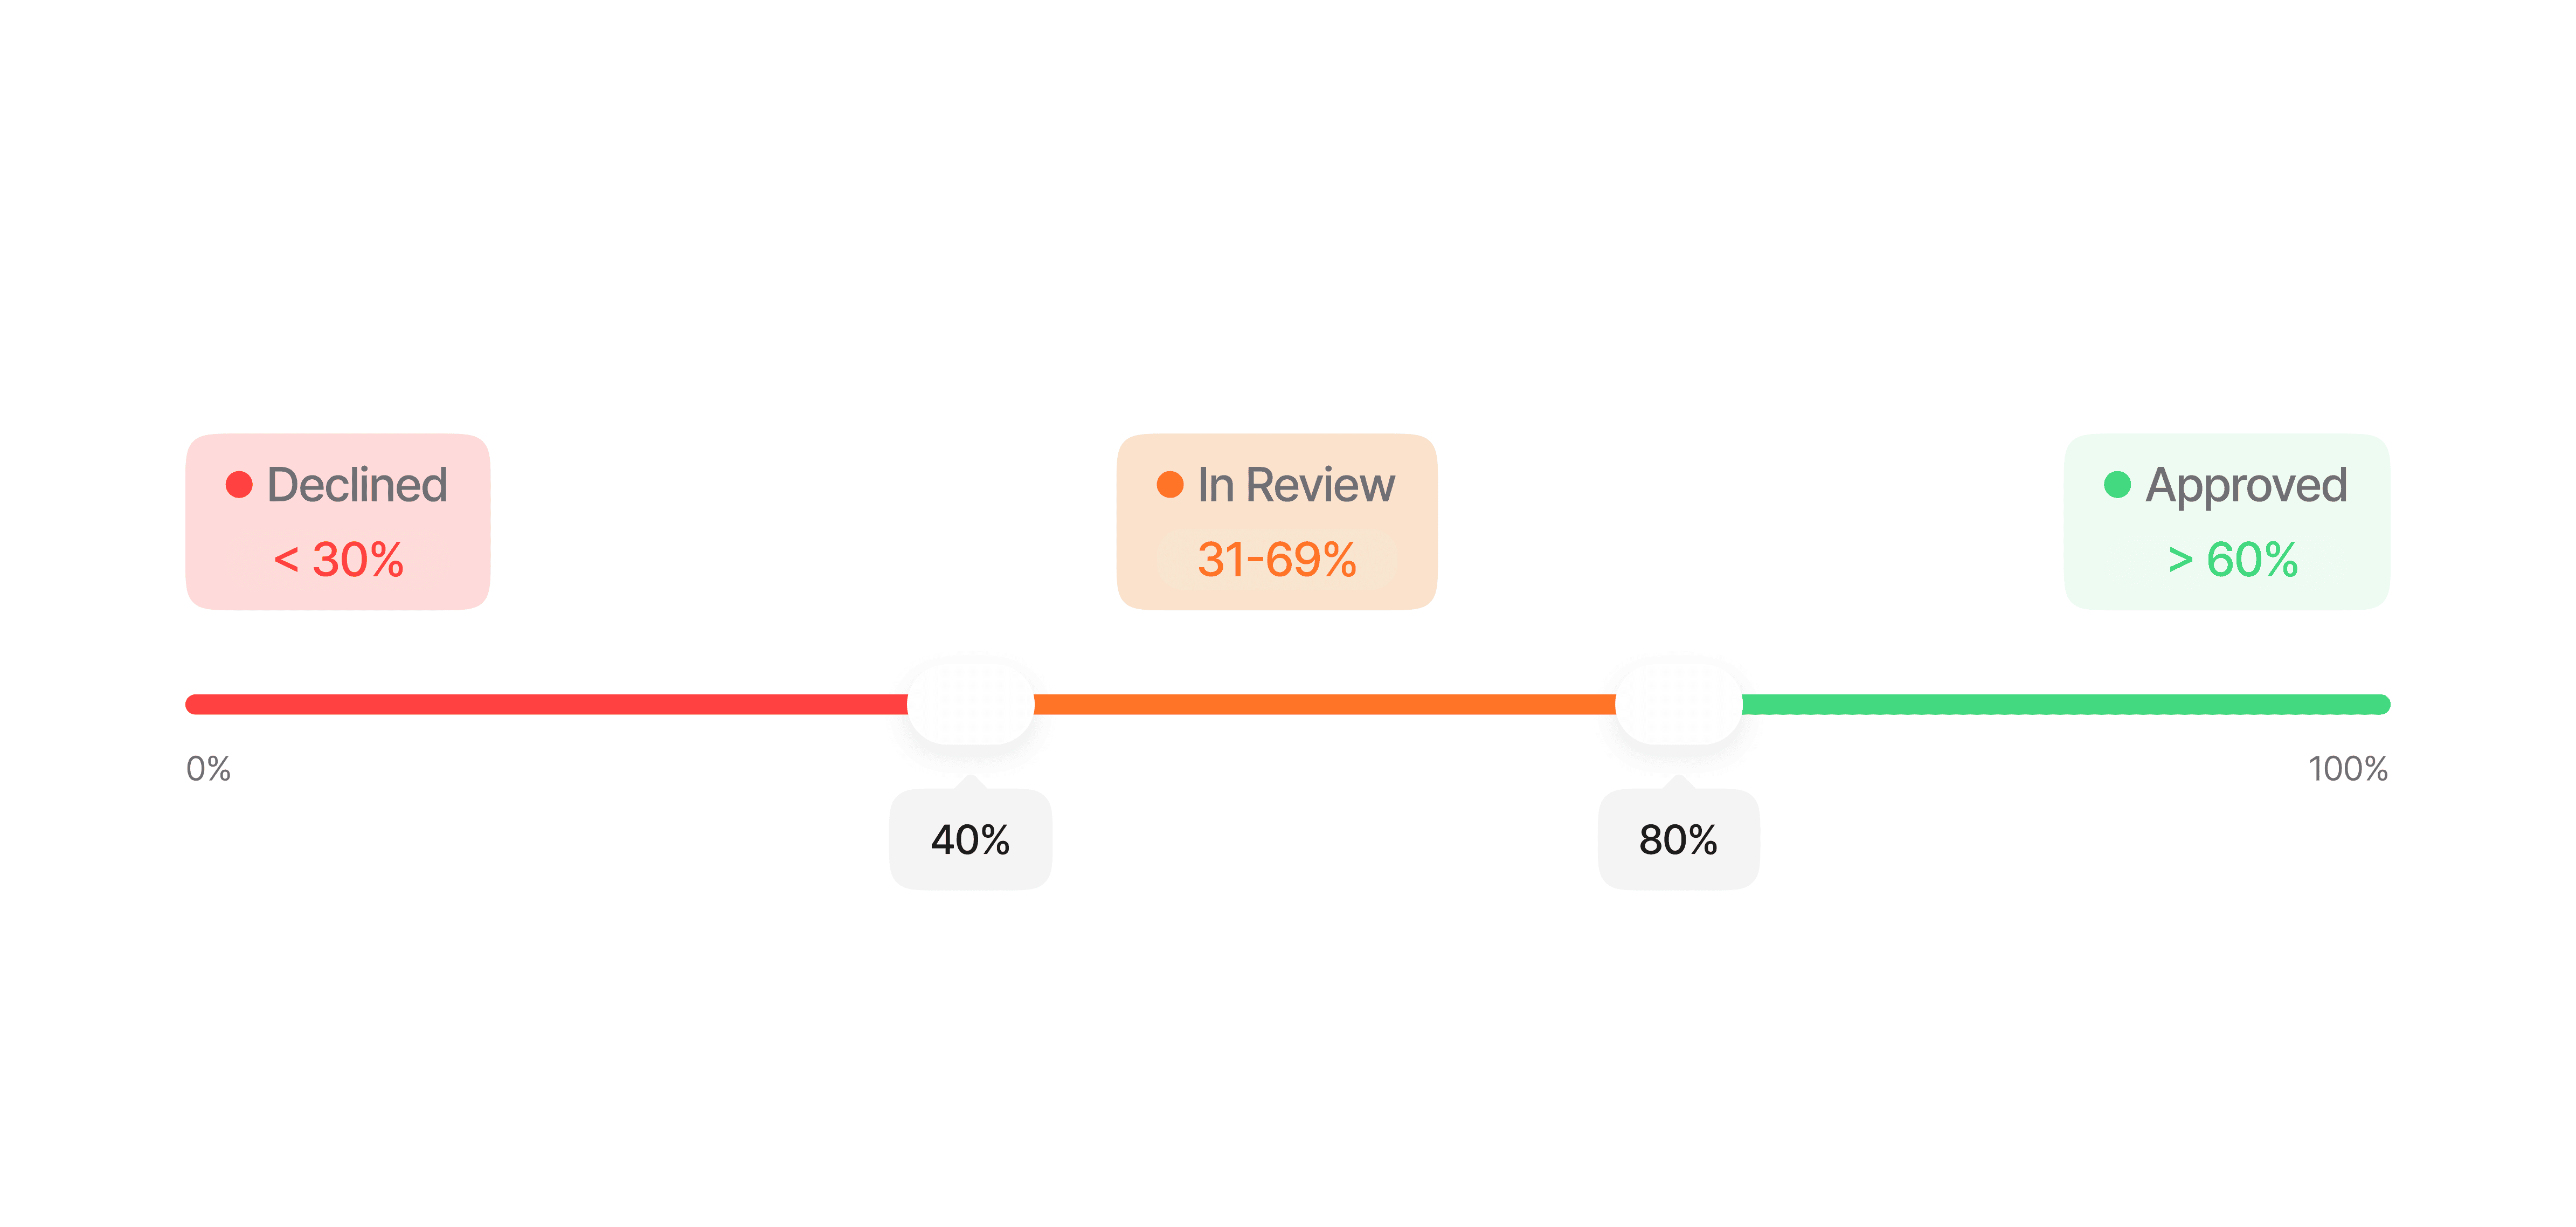
이 임계값은 위험 허용 수준과 보안 요구 사항에 따라 조정할 수 있으며, 다양한 사용 사례에 맞게 유연하게 적용할 수 있습니다.
재시도 및 조치 가능한 피드백
Didit 세션에서 수정 가능한 이유(조명 부족, 얼굴 위치 어긋남, 가림, 경계값에 가까운 점수 등)로 라이브니스 캡처가 실패하면 즉시 거부되지 않습니다. 사용자에게 구체적인 안내와 함께 재시도를 요청하며, 재시도 횟수는 설정할 수 있습니다.-
시도 횟수:
face_liveness_max_attempts는 세션당 라이브니스 제출의 총 횟수를 제어합니다. 기본값은 3(최초 시도 1회와 재시도 2회)이며, 워크플로 노드별로 설정할 수 있습니다(범위 1~3). -
재시도 피드백: 시도 횟수가 남아 있는 동안 재시도 가능한 실패가 발생하면 사용자는 라이브니스 단계에 머무르며, 조치 가능한
feedback_codes가 포함된 본문이 반환됩니다(Web 및 Mobile SDK는 이를 안내 메시지로 자동 표시합니다): -
재시도 가능 코드:
LOW_FACE_LUMINANCE(너무 어두움),HIGH_FACE_LUMINANCE(너무 밝음),NO_FACE_DETECTED,LOW_FACE_QUALITY,HIGH_FACE_OCCLUSION,LOW_LIVENESS_SCORE,MULTIPLE_FACES_DETECTED,AGE_NOT_DETECTED. -
캡처 조건에 대한 보장된 재시도:
LOW_FACE_LUMINANCE,HIGH_FACE_LUMINANCE,LOW_FACE_QUALITY,HIGH_FACE_OCCLUSION,NO_FACE_DETECTED는 사람이 아니라 사용자가 서 있는 공간의 상태를 나타냅니다. 시도가 이 코드로만 실패하면,face_liveness_max_attempts: 1로 구성된 워크플로에서도 사용자는 항상 위의 안내 메시지와 함께 두 번째 시도를 받게 됩니다. 그 밖의 모든 코드는 구성된 시도 횟수를 정확히 따릅니다. -
시도 소진 및 사기 대응: 시도 횟수를 모두 사용하면 계산된 상태가 적용됩니다(
Declined또는In Review). 확인된 프레젠테이션 공격(LIVENESS_FACE_ATTACK), 차단 목록 일치, 중복 얼굴은 즉시 거부되며 재시도되지 않습니다.
재시도는 세션 흐름에만 적용됩니다. 단독으로 사용하는
POST /v3/passive-liveness/ 엔드포인트는 상태를 저장하지 않으며 단일 요청으로 동작합니다. 재시도 시도 횟수가 없고 결과를 바로 반환합니다.작동 방식
비디오 셀피 캡처
사용자는 선택한 라이브니스 방식에 맞춘 간단하고 직관적인 인터페이스를 따라 진행합니다.
라이브니스 감지 분석
고급 알고리즘이 캡처된 미디어를 실시간으로 처리하여 스푸핑 시도를 감지합니다. 분석은 방식에 따라 다릅니다:
다중 계층 감지는 사진, 화면, 마스크, 딥페이크를 포함한 프레젠테이션 공격을 식별합니다.
3D 액션 및 플래시
3D 액션 및 플래시
- 사용자의 동작(예: 눈 깜빡임 또는 고개 끄덕임)이 올바르게 수행되었고 실제 사람에 의해 이루어졌는지 확인합니다
- 빛 패턴 반사를 분석하여 얼굴의 입체 구조를 검증합니다
- 딥러닝을 사용해 미세 표정과 기타 행동 신호를 평가합니다
- 행동 신호와 물리적 신호를 결합하여 가장 강력한 스푸핑 저항성을 제공합니다
3D 플래시
3D 플래시
- 30+ FPS에서 일련의 빛 패턴 반사를 처리하여 상세한 깊이 맵을 생성합니다
- 얼굴의 3D 특성을 확인하여 평면 또는 2D 스푸핑과 구별합니다
- 사용자 상호작용이 필요하지 않으며, 사용자 입장에서는 완전히 수동적으로 진행됩니다
패시브 라이브니스
패시브 라이브니스
- 단일 프레임에 딥러닝을 적용하여 질감 패턴과 아티팩트를 감지합니다
- 합성곱 신경망(CNN)이 얼굴 특징을 검증하고 이상 징후를 식별합니다
- 가장 빠른 방식이며, 단일 사진 캡처로 동작합니다
결과 처리 및 검증
시스템은 라이브니스 점수를 설정된 임계값과 비교하고 결과를 즉시 전달합니다.
결과는 API 응답, webhook으로 전달되거나, 컴플라이언스를 위한 상세한 감사 로그와 함께 비즈니스 콘솔에서 확인할 수 있습니다.