

 ابدأ الآن
 التكامل / SDKs
 التحقق من المستخدمين
 التحقق من الشركات
 مراقبة المعاملات
 سجل التغييرات
طرق كشف الحيوية
تطبق منصتنا ثلاث تقنيات متميزة لمكافحة الانتحال، كل منها مصممة لتلبية احتياجات أمنية وتجارب مستخدم مختلفة:| الطريقة | الوصف | مستوى الأمان | الأفضل لـ |
|---|---|---|---|
3D Action & Flash | • يجمع بين التحقق البيومتري متعدد العوامل وتسلسل إجراءات عشوائي وتحليل ديناميكي لأنماط الإضاءة. • في البداية، يُطلب من المستخدم تنفيذ إجراء بسيط—مثل الرمش بالعينين أو إيماءة الرأس—لضمان التفاعل في الوقت الفعلي. • بالتزامن مع ذلك، يُسقط النظام تسلسلاً من أنماط الإضاءة على الوجه، ويحلل الانعكاسات لتأكيد البنية ثلاثية الأبعاد للوجه. • تفحص خوارزميات التعلم العميق التعبيرات الدقيقة واستجابات انعكاس الضوء للتحقق من وجود شخص حي. • يوفر أعلى درجات الأمان عبر دمج الدلائل السلوكية (الإجراء) والفيزيائية (العمق المعتمد على الضوء)، مما يجعل الانتحال باستخدام الصور الثابتة أو مقاطع الفيديو أو حتى الأقنعة المتقدمة شبه مستحيل. | الأعلى | التطبيقات المصرفية، والرعاية الصحية، والتطبيقات الحكومية |
3D Flash | • يستخدم تحليل أنماط الإضاءة الديناميكية للتحقق من تضاريس الوجه دون اشتراط تفاعل من المستخدم. • يُسقط سلسلة من أنماط الإضاءة على الوجه بمعدل يزيد عن 30 إطاراً في الثانية، ويحلل الانعكاسات لإنشاء خريطة عمق. • تؤكد خريطة العمق هذه البنية ثلاثية الأبعاد للوجه، وتميزه عن الصور المسطحة أو محاولات الانتحال ثنائية الأبعاد. • يوفر تجربة سلسة مع الحفاظ على مستوى أمان عالٍ ضد هجمات العرض مثل الصور أو الشاشات. | عالي | الخدمات المالية، والوصول إلى الحسابات، والتحقق من الهوية |
Passive Liveness | • يعتمد على تحليل إطار واحد بالتعلم العميق لكشف علامات الحيوية. • يفحص الصورة بحثاً عن الشوائب والعيوب التصويرية وأنماط الملمس وغيرها من المؤشرات الدقيقة التي تميز الوجه الحقيقي عن محاولة انتحاله. • تتحقق شبكة عصبية التفافية (CNN) من ملامح الوجه وتحدد الحالات الشاذة، مثل تلك الناتجة عن الصور المطبوعة أو الشاشات الرقمية. • يوفر تحققاً سريعاً ومريحاً ولكنه يقدم مستوى أمان قياسياً، وهو مناسب لحالات الاستخدام منخفضة المخاطر. | قياسي | سيناريوهات الاحتكاك المنخفض، وتطبيقات المستهلكين |
الأمان المتقدم لطريقتَي 3D Flash و3D Action & Flash:
- صُممت هاتان الطريقتان لإحباط هجمات الانتحال المتطورة، مثل الأقنعة عالية الجودة والتزييف العميق وإعادة تشغيل الفيديو.
- عبر إسقاط أنماط إضاءة ديناميكية وتحليل انعكاساتها، تكتشفان كيفية تفاعل الضوء مع وجه ثلاثي الأبعاد حقيقي مقارنة بسطح مسطح أو اصطناعي.
- تضيف طريقة 3D Action & Flash طبقة أمان إضافية بإجراء عشوائي (مثل الرمش أو إيماءة الرأس)، مما يتطلب استجابات سلوكية في الوقت الفعلي لا يمكن للوسائط المسجلة مسبقاً أو الهويات الاصطناعية محاكاتها.
- أثبتت هاتان الطريقتان قدرتهما على تقديم دقة عالية ومعدلات قبول خاطئ منخفضة، وهما مثاليتان للبيئات الحساسة وعالية المخاطر.
الحدود القابلة للضبط
يمكنك تخصيص مستويات الأمان عبر تعيين حدود مختلفة لدرجات الحيوية. على سبيل المثال: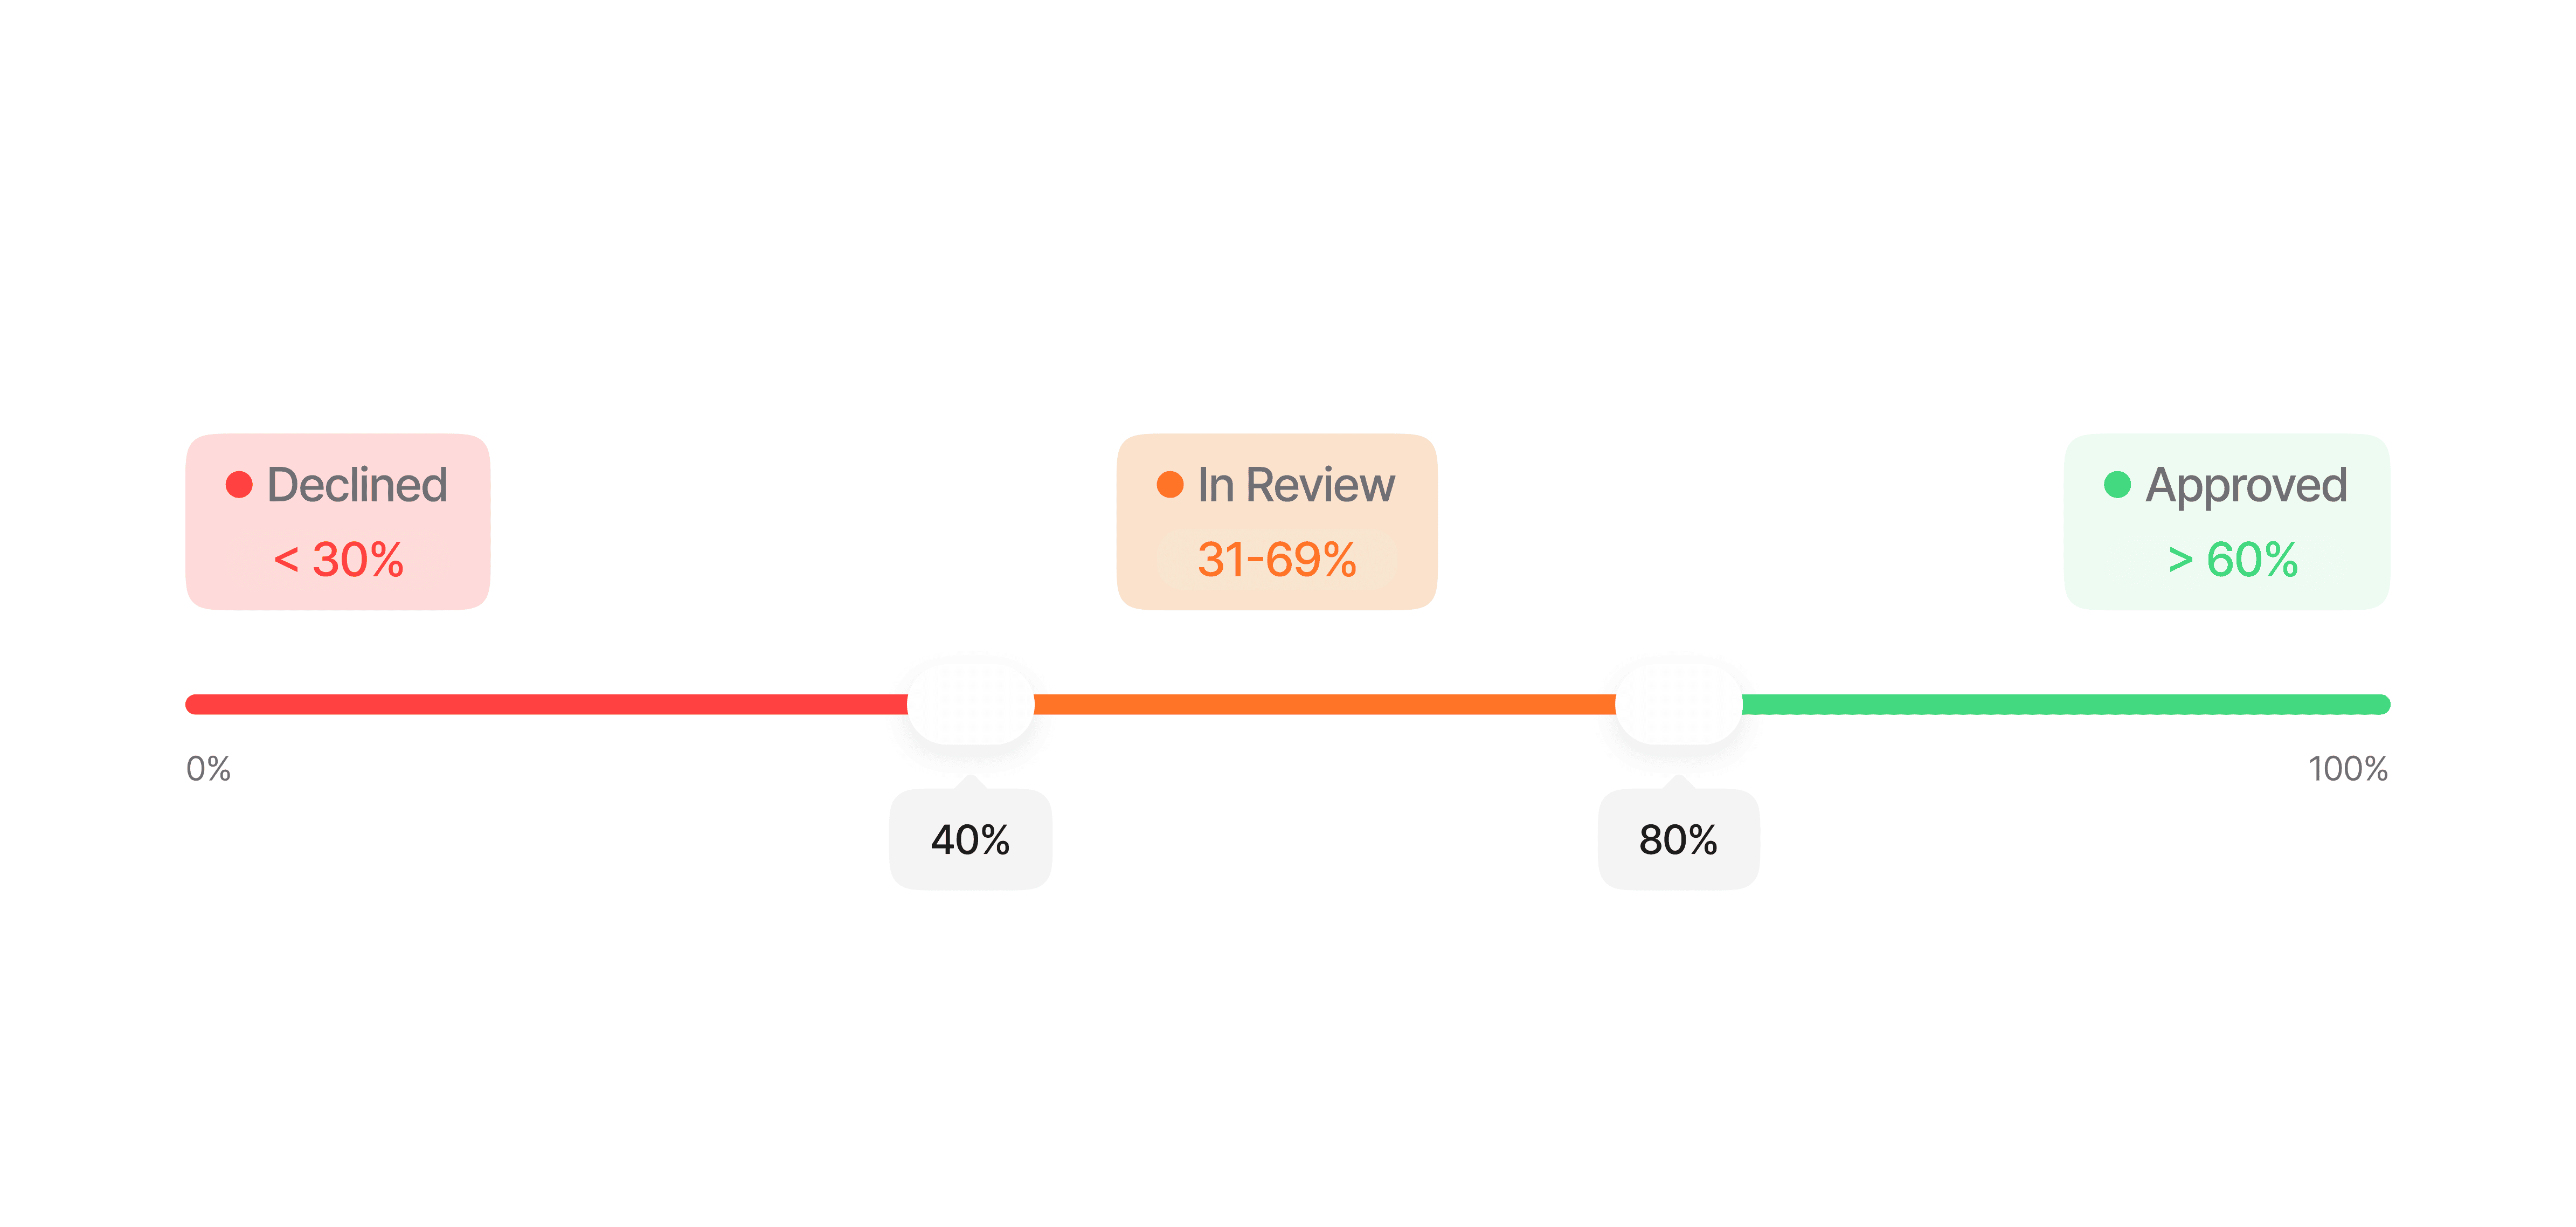
يمكن تعديل هذه الحدود بناءً على قدرتك على تحمل المخاطر ومتطلبات الأمان الخاصة بك، مما يوفر مرونة عبر مختلف حالات الاستخدام.
عمليات إعادة المحاولة والملاحظات التوجيهية
في جلسة Didit، لا يؤدي التقاط الحيوية الذي يفشل لـ سبب قابل للإصلاح (إضاءة ضعيفة، أو عدم توسيط الوجه، أو الحجب، أو درجة حدية) إلى الرفض المباشر. بل يُطلب من المستخدم إعادة المحاولة مع إرشادات محددة، وذلك حتى عدد محاولات قابل للتهيئة.-
ميزانية المحاولات — يتحكم المعامل
face_liveness_max_attemptsفي إجمالي عدد عمليات إرسال الحيوية لكل جلسة. القيمة الافتراضية هي 3 (محاولة أولية واحدة بالإضافة إلى عمليتي إعادة محاولة)، وهي قابلة للتهيئة لكل عقدة في سير العمل (النطاق 1–3). -
ملاحظات إعادة المحاولة — طالما بقيت محاولات متاحة، فإن الفشل القابل لإعادة المحاولة يُبقي المستخدم في خطوة كشف الحيوية ويعيد payload يتضمن
feedback_codesقابلة للتنفيذ (تعرضها حزم SDK للويب والهاتف المحمول كرسائل إرشادية تلقائياً): -
الرموز القابلة لإعادة المحاولة —
LOW_FACE_LUMINANCE(مظلم للغاية)، وHIGH_FACE_LUMINANCE(شديد السطوع)، وNO_FACE_DETECTED، وLOW_FACE_QUALITY، وHIGH_FACE_OCCLUSION، وLOW_LIVENESS_SCORE، وMULTIPLE_FACES_DETECTED، وAGE_NOT_DETECTED. -
إعادة محاولة مضمونة لظروف الالتقاط — تصف الرموز
LOW_FACE_LUMINANCEوHIGH_FACE_LUMINANCEوLOW_FACE_QUALITYوHIGH_FACE_OCCLUSIONوNO_FACE_DETECTEDالغرفة التي يتواجد فيها المستخدم، وليس الشخص نفسه. عندما تفشل محاولة بسبب هذه الرموز وحدها، يحصل المستخدم دائماً على محاولة ثانية مع الرسالة الإرشادية المذكورة أعلاه، حتى في سير عمل تمت تهيئته بالقيمةface_liveness_max_attempts: 1. وتتبع جميع الرموز الأخرى الميزانية المحددة بدقة. -
استنفاد المحاولات والاحتيال — بمجرد استنفاد الميزانية، يتم تطبيق الحالة المحسوبة (
DeclinedأوIn Review). أما هجمات العرض المؤكدة (LIVENESS_FACE_ATTACK)، وتطابقات قائمة الحظر، والوجوه المكررة، فيتم رفضها فوراً ولا يُعاد المحاولة فيها أبداً.
تنطبق عمليات إعادة المحاولة على سير الجلسة فقط. أما endpoint المستقل
POST /v3/passive-liveness/ فهو عديم الحالة ويُنفَّذ مرة واحدة فقط — حيث يُعيد النتيجة مباشرة دون ميزانية لإعادة المحاولة.آلية العمل
التقاط فيديو سيلفي
يتم توجيه المستخدم من خلال واجهة بسيطة وبديهية مصممة خصيصاً لطريقة كشف الحيوية المحددة.
تحليل كشف الحيوية
تعالج خوارزميات متقدمة الوسائط الملتقطة في الوقت الفعلي لاكتشاف محاولات الانتحال. ويختلف التحليل باختلاف الطريقة:
يكتشف النظام متعدد الطبقات هجمات العرض بما في ذلك الصور والشاشات والأقنعة والتزييف العميق.
3D Action & Flash
3D Action & Flash
- يتحقق من حركة المستخدم (مثل الرمش أو إيماءة الرأس) للتأكد من تنفيذها بشكل صحيح وأنها حية
- يحلل انعكاسات أنماط الضوء للتحقق من البنية ثلاثية الأبعاد للوجه
- يستخدم التعلم العميق لتقييم التعبيرات الدقيقة وغيرها من الإشارات السلوكية
- يجمع بين الإشارات السلوكية والفيزيائية لتحقيق أقوى مقاومة للانتحال
3D Flash
3D Flash
- يعالج تسلسلاً من انعكاسات أنماط الضوء بمعدل 30+ إطاراً في الثانية لإنشاء خريطة عمق مفصلة
- يؤكد الخصائص ثلاثية الأبعاد للوجه، مما يميزه عن محاولات الانتحال المسطحة أو ثنائية الأبعاد
- لا يتطلب أي تفاعل من المستخدم — فهو سلبي بالكامل من منظور المستخدم
Passive Liveness
Passive Liveness
- يطبق التعلم العميق على إطار واحد لاكتشاف أنماط النسيج والتشوّهات
- تتحقق شبكة عصبية تلافيفية (CNN) من ملامح الوجه وتحدد الحالات الشاذة
- أسرع طريقة — تعمل من خلال التقاط صورة واحدة
معالجة النتائج والتحقق منها
يقارن النظام درجة الحيوية بالـ حدود التي قمت بتهيئتها ويقدم النتائج فوراً.
يتم تسليم النتائج عبر استجابة API، أو webhook، أو يمكن عرضها في Business Console مع سجلات التدقيق المفصلة للامتثال.