

 Commencer
 Intégrer / SDK
 Vérification des utilisateurs
 Vérification d'entreprise
 Surveillance des transactions
 Journal des modifications
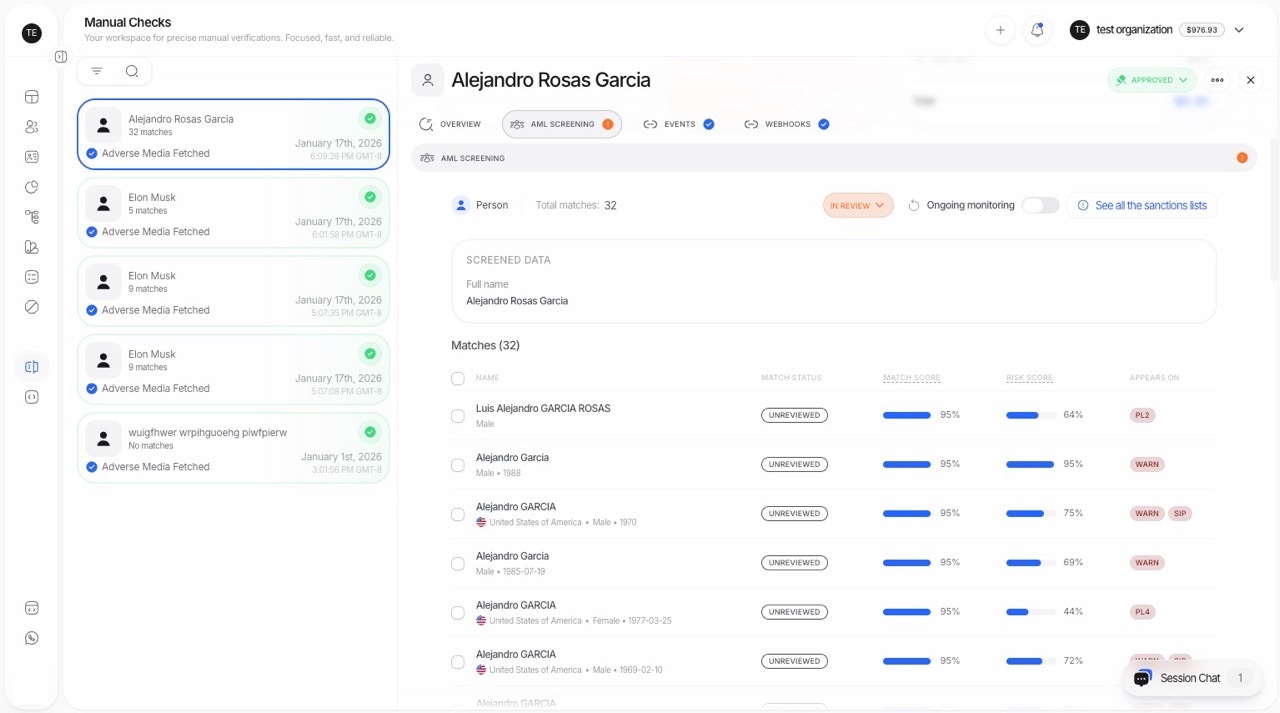
Concepts clés : score de correspondance et score de risque
Didit utilise un système à deux scores pour le filtrage AML :Score de correspondance (confiance dans l’identité)
- Question : Cette correspondance concerne-t-elle la même personne que celle que nous filtrons ?
- Facteurs : Similarité du nom, date de naissance, pays/nationalité, numéro de document
- Objectif : Classe la correspondance comme Faux positif ou Non examiné (correspondance possible)
- Seuil : Seuil du score de correspondance (par défaut : 93)
Score de risque (niveau de risque de l’entité)
- Question : Quel est le niveau de risque de cette entité s’il s’agit effectivement de la même personne ?
- Facteurs : Risque lié au pays, catégorie (PEP/sanctions/etc.), casier judiciaire
- Objectif : Détermine le statut AML final (Approuvé/En cours d’examen/Refusé)
- Seuils : Seuil d’approbation (par défaut : 80) et seuil d’examen (par défaut : 100)
Statuts d’examen des correspondances
Chaque correspondance AML se voit attribuer un statut d’examen basé sur son score de correspondance :Conseil : Vous pouvez modifier le statut d’examen d’une correspondance dans la Console en consultant la vue d’ensemble AML ou en cliquant sur une correspondance spécifique pour afficher ses détails.
Fonctionnalités clés
1. Extraction complète des données
- Extraction précise : Extrayez les données à partir des informations fournies par l’utilisateur ou des documents d’identité à l’aide d’une technologie OCR avancée.
- Logique floue : Prenez en compte les variantes de noms et les fautes d’orthographe pour garantir une capture exhaustive des données.
2. Couverture étendue des listes de surveillance
Effectuez des vérifications sur plusieurs catégories, notamment :- Listes de sanctions : Émanant d’organismes gouvernementaux et internationaux.
- Personnes politiquement exposées (PEP) : Personnes exerçant des fonctions publiques de premier plan.
- Antécédents criminels : Y compris les bases de données pénales mondiales et locales.
- Mentions dans la presse négative : Articles de presse et rapports sur la criminalité financière et d’autres risques.
- Listes de surveillance personnalisées : Configurables selon les besoins spécifiques du client.
3. Algorithmes de correspondance avancés
- Correspondance floue : Détectez de légères variations dans les noms ou les détails pour garantir une correspondance précise.
- Points de données multiples : Utilisez le nom, la date de naissance, la nationalité et d’autres identifiants pour un filtrage approfondi.
- Logique Golden Key : Correspondance du numéro de document pouvant outrepasser les scores pour une identification définitive.
4. Évaluation du risque à double score
Chaque correspondance reçoit DEUX scores :
Statut d’examen de la correspondance (selon le score de correspondance) :
- Faux positif : Score de correspondance inférieur au seuil - il ne s’agit probablement PAS de la même personne
- Non examiné : Score de correspondance supérieur ou égal au seuil - nécessite un examen
- Approuvé : Toutes les correspondances non examinées ont des scores de risque faibles
- En cours d’examen : Au moins une correspondance non examinée a un score de risque moyen-élevé
- Refusé : Au moins une correspondance non examinée a un score de risque très élevé
5. Filtrage détaillé de la presse négative
Filtrez parmi un large éventail de catégories de presse négative, notamment :- Délits financiers : Blanchiment d’argent, détournement de fonds, et plus encore.
- Crimes avec violence : Agressions, meurtres et infractions connexes.
- Terrorisme : Implication ou soutien à des activités terroristes.
- Stupéfiants : Trafic de stupéfiants et délits connexes.
- Fraude : Divers types de fraudes et de pratiques trompeuses.
- Infractions réglementaires : Non-respect des exigences de conformité réglementaire.
6. Paramètres de filtrage personnalisables
- Sensibilité ajustable : Configurez la sensibilité du filtrage selon l’appétence au risque de votre organisation.
- Listes de surveillance personnalisables : Sélectionnez les listes de surveillance et les catégories à inclure dans le processus de filtrage pour répondre à des besoins spécifiques.
Seuils configurables
Vous pouvez personnaliser les niveaux de sécurité en définissant différents seuils : Configuration du score de correspondance :
Seuils du score de risque (statut final) :
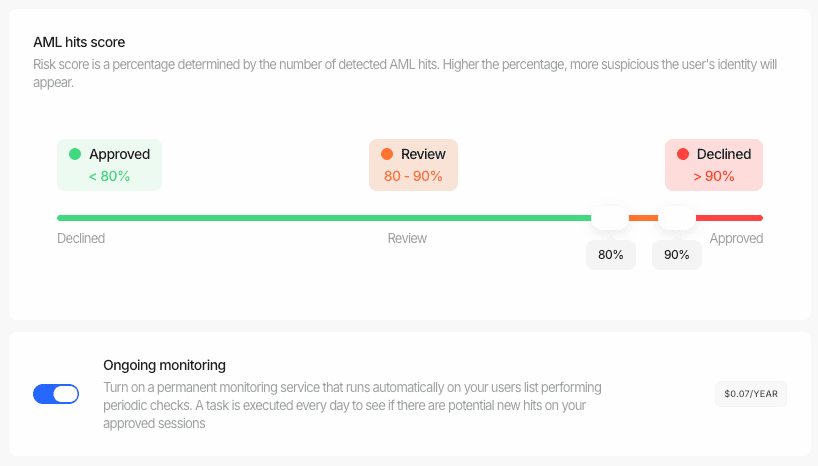
Ces seuils peuvent être ajustés selon votre tolérance au risque et vos exigences de sécurité.
Comment ça fonctionne
Notre processus de filtrage AML identifie efficacement les risques potentiels tout en minimisant les délais pour les utilisateurs légitimes.Extraction des données
Le système extrait les informations pertinentes à partir des données fournies par l’utilisateur ou des pièces d’identité téléversées.
Filtrage sur les listes de surveillance
Les données extraites sont recoupées en temps réel avec 1,300+ listes de surveillance mondiales et bases de données :
- Listes de sanctions — Organismes gouvernementaux et internationaux (OFAC, UE, ONU, etc.)
- Personnes politiquement exposées (PEP) — Individus exerçant des fonctions publiques de premier plan
- Casier judiciaire — Bases de données criminelles mondiales et locales
- Presse négative — Articles de presse et rapports sur la criminalité financière
- Listes de surveillance personnalisées — Configurables selon vos besoins
Calcul du score de correspondance
Pour chaque correspondance potentielle, le système calcule un score de confiance de l’identité — la probabilité qu’il s’agisse de la même personne.
- Score de correspondance inférieur au seuil (par défaut : 93) → classé comme Faux positif
- Score de correspondance égal ou supérieur au seuil → classé comme Non examiné (correspondance possible)
- Clé dorée : la correspondance du numéro de document peut forcer le score à 100% pour une identification définitive
Calcul du score de risque
Pour les correspondances qui ne sont pas des faux positifs, le système calcule le niveau de risque de l’entité :
Détermination du statut final
Basé sur le score de risque le plus élevé parmi toutes les correspondances qui ne sont pas des faux positifs :
Si toutes les correspondances sont des faux positifs, le résultat est Approuvé (aucune correspondance crédible trouvée).
Génération des résultats
Un rapport détaillé est généré en toute transparence :
- Le score de correspondance et le score de risque de chaque correspondance avec le détail des calculs
- La classification de la correspondance (Faux positif vs Non examiné vs Confirmé)
- La base de données source et les détails de la catégorie pour chaque résultat
- Les résultats sont transmis via réponse API, webhook ou la Business Console
- Prise de décision automatique basée sur vos seuils de score de risque configurés
Référence des données de correspondance AML
Chaque correspondance AML renvoyée dans la réponse API contient des informations détaillées sur l’entité correspondante. Vous trouverez ci-dessous les champs clés et leurs valeurs possibles.Catégories de jeux de données
Le champdatasets présent sur chaque correspondance indique les catégories de bases de données de conformité dans lesquelles l’entité a été trouvée. Valeurs possibles :
Correspondances de sanctions
Le tableausanction_matches contient les détails relatifs à chaque liste de sanctions où l’entité a été trouvée. Champs clés :
Correspondances d’avertissements
Le tableauwarning_matches contient les détails des correspondances issues des listes d’avertissements, de mesures d’exécution réglementaires et des listes associées. Le champ additional_data peut inclure un tableau data.case_details contenant des informations structurées sur le dossier.
Types de dossiers d’avertissement
Le champcase_type au sein de additional_data.data.case_details[] décrit la nature du dossier d’avertissement. Valeurs connues :