

 Commencer
 Intégrer / SDK
 Vérification des utilisateurs
 Vérification d'entreprise
 Surveillance des transactions
 Journal des modifications
⚠️ Important : Le score de correspondance détermine la classification individuelle de la correspondance, et NON le statut AML final. Le statut AML final (Approuvé/En cours d’examen/Refusé) est déterminé par le score de risque des correspondances qui ne sont pas des faux positifs.
Présentation générale
Lors du filtrage d’une personne par rapport aux listes de surveillance AML, chaque correspondance potentielle reçoit un score de correspondance de 0 à 100. Ce score répond à la question suivante : « Cette correspondance concerne-t-elle réellement la même personne que celle que nous filtrons ? »Score de correspondance vs score de risque
Comment le score de correspondance détermine le statut d’examen
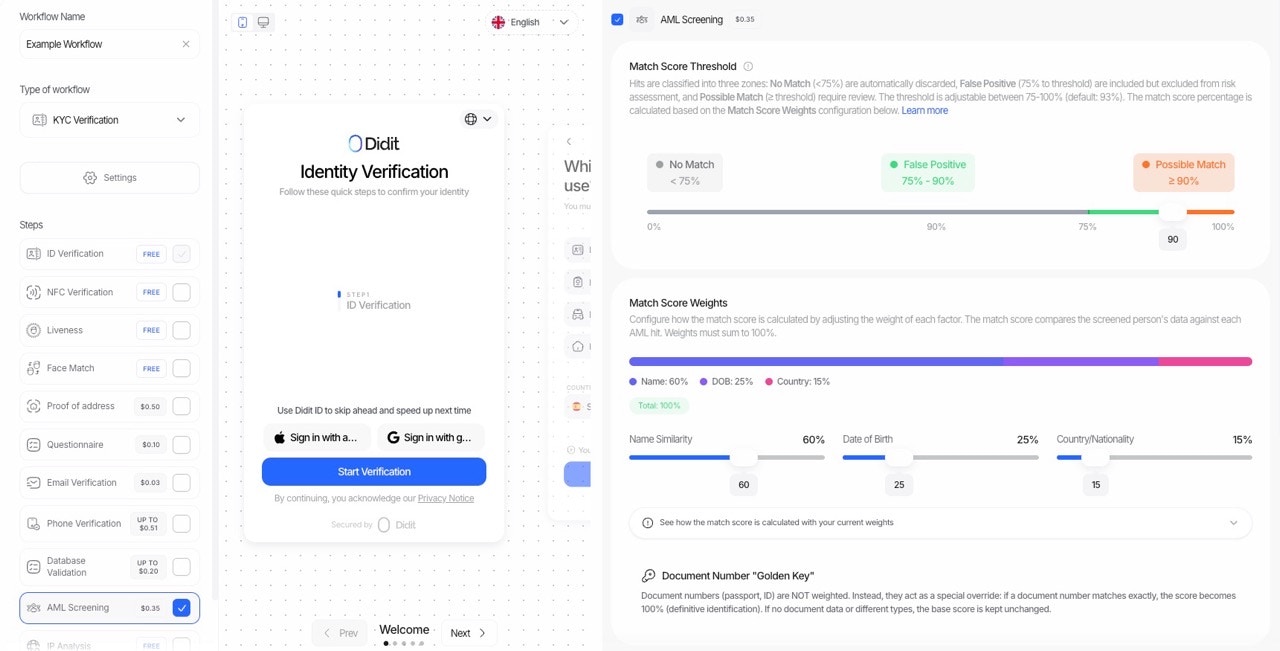
Chaque correspondance est classée en fonction de son score de correspondance :Seuil par défaut : 93%Exemple : Avec un seuil de 93 :
- Correspondance avec un score de 85 → Faux positif (écartée automatiquement)
- Correspondance avec un score de 95 → Non examiné (nécessite un examen, le score de risque détermine l’urgence)
Explication des statuts d’examen
Toutes les correspondances AML commencent avec l’un des deux statuts initiaux en fonction de leur score de correspondance :
Après examen manuel, les responsables de la conformité peuvent modifier le statut pour le définir comme :
Astuce : Vous pouvez modifier le statut d’examen d’une correspondance dans la Console en consultant la vue d’ensemble AML ou en cliquant sur une correspondance spécifique pour afficher ses détails.
Comment le score de correspondance est calculé
Étape 1 : Calcul du score de base
Le score de base est calculé à l’aide de trois composants avec des poids configurables :Remarque : La somme des poids doit toujours être égale à 100%.
Étape 2 : Logique de la « clé d’or » du numéro de document
Après avoir calculé le score de base, le numéro de document est évalué séparément à l’aide d’une logique de remplacement spéciale :
Cette approche reconnaît qu’un numéro de document correspondant est une preuve définitive d’identité (la « clé d’or »), tandis que des types de documents discordants ne doivent pas pénaliser le score.
Détails de la notation par composant
Similitude du nom (0-100)
La mise en correspondance des noms utilise l’algorithme WRatio de RapidFuzz, qui est robuste face aux éléments suivants :- Fautes de frappe et d’orthographe
- Différences dans l’ordre des mots (« John Smith » vs « Smith, John »)
- Variantes du deuxième prénom (« Robert J. Smith » vs « Robert James Smith »)
- Différences de longueur
Notation de la date de naissance
Important : Lorsque le résultat ne fournit qu’une année (par ex., « 1974 »), la correspondance sur cette année compte comme une correspondance totale, car c’est la seule information disponible à vérifier.
Notation du pays/de la nationalité
Le système effectue automatiquement la conversion entre :
- Les codes ISO alpha-2 (ES)
- Les codes ISO alpha-3 (ESP)
- Les noms complets de pays (Spain)
citizenship en plus de countries.
Normalisation des scores (repondération)
Lorsque des données manquent, que ce soit pour la personne filtrée ou dans le résultat correspondant, le système utilise la normalisation des scores pour éviter d’appliquer une pénalité pour des informations indisponibles.Exemple : Filtrage par nom uniquement
Si vous effectuez un filtrage avec seulement un nom (sans date de naissance ni pays) :
Résultat : Le score du nom devient l’intégralité du score de correspondance.
Exemple : Pays manquant sur le résultat correspondant
Si le résultat correspondant n’a pas de données de pays mais possède une date de naissance :
Cela garantit une notation équitable quelle que soit la disponibilité des données.
Options de configuration
Vous pouvez personnaliser le calcul du score de correspondance via l’API ou les paramètres du workflow :Seuil du score de correspondance
Poids (la somme doit être égale à 100)
Exemple de requête API
Réponse : Détail du score
Chaque correspondance dans la réponse comprend :match_score— Le score de correspondance calculé (0-100)risk_score— Le score de risque calculé (0-100) - voir Score de risquereview_status— « False Positive » ou « Unreviewed » selon le seuil du score de correspondancescore_breakdown— Détail approfondi du calcul du score de correspondance
Flux complet : Du score de correspondance au statut AML final
Exemples de calcul
Exemple 1 : Correspondance forte → Non examiné
Données filtrées :- Nom : “Robert J. Smith”
- Date de naissance : “1985-03-15”
- Pays : “US”
- Nom : “Robert James Smith”
- Date de naissance : “1985”
- Pays : “United States”
- Score du nom : 90% (correspondance approximative)
- Score de la date de naissance : 100% (la correspondance ne contient que l’année et celle-ci correspond)
- Score du pays : 100% (correspondance exacte)
Exemple 2 : Correspondance faible → Faux positif
Données filtrées :- Nom : “John Smith”
- Date de naissance : “1990-05-20”
- Pays : “US”
- Nom : “Johnny Smithson”
- Date de naissance : “1975”
- Pays : “Canada”
- Score du nom : 72% (correspondance approximative faible)
- Score de la date de naissance : -100% (pénalité pour divergence d’année)
- Score du pays : -50% (pénalité pour divergence de pays)
Exemple 3 : Remplacement par Golden Key
Données filtrées :- Nom : “John D. Smith”
- Numéro de document : “A12345678”
- Nom : “Jonathan David Smith”
- Numéro de document : “A12345678”
- Score de base : ~70 (correspondance approximative du nom)
- Numéro de document : CORRESPONDANCE (correspondance exacte)
Gestion des statuts d’examen
Après la classification initiale, vous pouvez mettre à jour manuellement le statut d’examen de chaque correspondance :Dans la console
- Accédez à la vue d’ensemble AML de la session
- Cliquez sur une correspondance spécifique pour afficher les détails
- Utilisez le menu déroulant de statut pour modifier le statut d’examen :
- Correspondance confirmée — Confirmez que la correspondance concerne la même personne
- Faux positif — Indiquez que la correspondance est un faux positif
- Non concluante — Impossible à déterminer
Bonnes pratiques
- Commencez avec le seuil par défaut (93) — Cela offre un bon équilibre entre la détection des véritables correspondances et le filtrage des faux positifs.
- Abaissez le seuil pour les scénarios à haut risque — Si vous devez faire preuve de plus de prudence, abaissez le seuil de score de correspondance pour détecter davantage de correspondances potentielles.
- Utilisez les numéros de document lorsqu’ils sont disponibles — Ils fournissent la confirmation d’identité la plus fiable et peuvent remplacer les scores de correspondance faibles.
- Examinez les poids normalisés — Vérifiez les champs de poids normalisés dans la décomposition du score pour comprendre comment les données manquantes ont affecté le score.
- Surveillez les taux de faux positifs — Si un trop grand nombre de correspondances légitimes sont marquées comme faux positifs, abaissez le seuil.