

 Inizia
 Integrazione / SDK
 Verifica degli utenti
 Verifica aziendale
 Monitoraggio delle transazioni
 Changelog
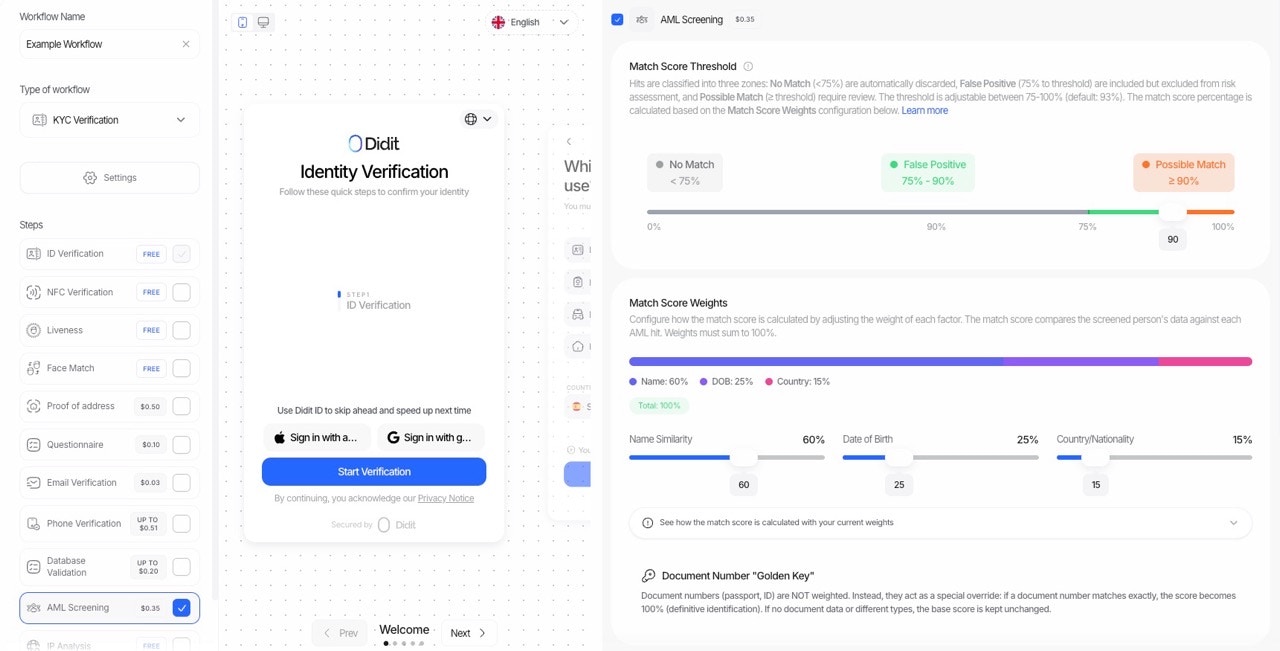
⚠️ Importante: il Punteggio di corrispondenza determina la classificazione della singola corrispondenza, NON lo stato AML finale. Lo stato AML finale (Approvata/In revisione/Rifiutata) è determinato dal Punteggio di rischio delle corrispondenze che non sono falsi positivi.
Panoramica
Quando si esegue lo screening di una persona rispetto alle watchlist AML, ogni potenziale corrispondenza riceve un punteggio di corrispondenza da 0 a 100. Questo punteggio risponde alla domanda: «Questa corrispondenza è effettivamente la stessa persona sottoposta a screening?»Punteggio di corrispondenza e Punteggio di rischio
In che modo il punteggio di corrispondenza determina lo stato di revisione
Ogni corrispondenza viene classificata in base al relativo punteggio di corrispondenza:Soglia predefinita: 93%Esempio: con una soglia pari a 93:
- Corrispondenza con punteggio 85 → Falso positivo (scartata automaticamente)
- Corrispondenza con punteggio 95 → Non esaminata (richiede revisione, il punteggio di rischio ne determina l’urgenza)
Descrizione degli stati di revisione
Tutte le corrispondenze AML iniziano con uno dei due stati iniziali in base al loro punteggio di corrispondenza:
Dopo la revisione manuale, i responsabili della compliance possono aggiornare lo stato in:
Suggerimento: puoi modificare lo stato di revisione di una corrispondenza nella Console visualizzando la panoramica AML o facendo clic su una corrispondenza specifica per visualizzarne i dettagli.
Come viene calcolato il punteggio di corrispondenza
Passaggio 1: calcolo del punteggio di base
Il punteggio di base viene calcolato utilizzando tre componenti con pesi configurabili:Nota: la somma dei pesi deve essere sempre pari al 100%.
Passaggio 2: logica “Golden Key” del numero del documento
Dopo aver calcolato il punteggio di base, il numero del documento viene valutato separatamente utilizzando una speciale logica di sovrascrittura:
Questo approccio riconosce che la corrispondenza del numero del documento costituisce una prova definitiva dell’identità (la “Golden Key”), mentre tipi di documento non coincidenti non dovrebbero penalizzare il punteggio.
Dettagli sul punteggio dei componenti
Similarità del nome (0-100)
Il confronto dei nomi utilizza l’algoritmo WRatio di RapidFuzz, che è resistente a:- Errori di battitura e di ortografia
- Differenze nell’ordine delle parole (“John Smith” vs “Smith, John”)
- Variazioni del secondo nome (“Robert J. Smith” vs “Robert James Smith”)
- Differenze di lunghezza
Punteggio della data di nascita
Importante: quando la corrispondenza fornisce solo un anno (ad es. “1974”), la corrispondenza con quell’anno conta come corrispondenza completa perché è l’unica informazione disponibile da verificare.
Punteggio di paese/nazionalità
Il sistema converte automaticamente tra:
- Codici ISO alpha-2 (ES)
- Codici ISO alpha-3 (ESP)
- Nomi completi dei paesi (Spain)
citizenship oltre a countries.
Normalizzazione del punteggio (ripesatura)
Quando mancano dati della persona sottoposta a screening o della corrispondenza, il sistema utilizza la normalizzazione del punteggio per evitare penalizzazioni dovute a informazioni non disponibili.Esempio: screening solo con nome
Se esegui lo screening solo con un nome (senza data di nascita o paese):
Risultato: il punteggio del nome diventa l’intero punteggio di corrispondenza.
Esempio: paese mancante nella corrispondenza
Se la corrispondenza non dispone dei dati sul paese ma ha la data di nascita:
Ciò garantisce un calcolo equo del punteggio indipendentemente dalla disponibilità dei dati.
Opzioni di configurazione
Puoi personalizzare il calcolo del punteggio di corrispondenza tramite l’API o le impostazioni del workflow:Soglia del punteggio di corrispondenza
Pesi (la somma deve essere 100)
Esempio di richiesta API
Risposta: dettaglio del punteggio
Ciascuna corrispondenza nella risposta include:match_score— Il punteggio di corrispondenza calcolato (0-100)risk_score— Il punteggio di rischio calcolato (0-100) - vedi Punteggio di rischioreview_status— “Falso positivo” o “Non esaminato” in base alla soglia del punteggio di corrispondenzascore_breakdown— Dettaglio completo del calcolo del punteggio di corrispondenza
Flusso completo: dal punteggio di corrispondenza allo stato AML finale
Esempi di calcolo
Esempio 1: Corrispondenza forte → Non revisionato
Dati sottoposti a screening:- Nome: “Robert J. Smith”
- Data di nascita: “1985-03-15”
- Paese: “US”
- Nome: “Robert James Smith”
- Data di nascita: “1985”
- Paese: “United States”
- Punteggio nome: 90% (corrispondenza approssimata)
- Punteggio data di nascita: 100% (la corrispondenza contiene solo l’anno, l’anno coincide)
- Punteggio paese: 100% (corrispondenza esatta)
Esempio 2: Corrispondenza debole → Falso positivo
Dati sottoposti a screening:- Nome: “John Smith”
- Data di nascita: “1990-05-20”
- Paese: “US”
- Nome: “Johnny Smithson”
- Data di nascita: “1975”
- Paese: “Canada”
- Punteggio nome: 72% (corrispondenza approssimata debole)
- Punteggio data di nascita: -100% (penalità per mancata corrispondenza dell’anno)
- Punteggio paese: -50% (penalità per mancata corrispondenza del paese)
Esempio 3: Sovrascrittura tramite Golden Key
Dati sottoposti a screening:- Nome: “John D. Smith”
- Numero di documento: “A12345678”
- Nome: “Jonathan David Smith”
- Numero di documento: “A12345678”
- Punteggio base: ~70 (corrispondenza approssimata del nome)
- Numero di documento: CORRISPONDENZA (corrispondenza esatta)
Gestione dello stato di revisione
Dopo la classificazione iniziale, puoi aggiornare manualmente lo stato di revisione di ciascuna corrispondenza:Nella Console
- Vai alla panoramica AML della sessione
- Fai clic su una corrispondenza specifica per visualizzarne i dettagli
- Usa il menu a discesa dello stato per modificare lo stato di revisione:
- Corrispondenza confermata — Verifica che si tratti della stessa persona
- Falso positivo — Contrassegna la corrispondenza come non corrispondente
- Non conclusivo — Impossibile stabilirlo
Buone pratiche
- Inizia con la soglia predefinita (93) — Offre un buon equilibrio tra l’individuazione di corrispondenze reali e l’esclusione dei falsi positivi.
- Abbassa la soglia per scenari ad alto rischio — Se devi adottare maggiore cautela, abbassa la soglia del punteggio di corrispondenza per intercettare più potenziali corrispondenze.
- Usa i numeri di documento quando disponibili — Forniscono la conferma d’identità più solida e possono sovrascrivere punteggi di corrispondenza bassi.
- Esamina i pesi normalizzati — Verifica i campi dei pesi normalizzati nel dettaglio del punteggio per comprendere come i dati mancanti abbiano influito sul punteggio.
- Monitora i tassi di falsi positivi — Se troppe corrispondenze legittime vengono contrassegnate come falsi positivi, abbassa la soglia.