

 Inizia
 Integrazione / SDK
 Verifica degli utenti
 Verifica aziendale
 Monitoraggio delle transazioni
 Changelog
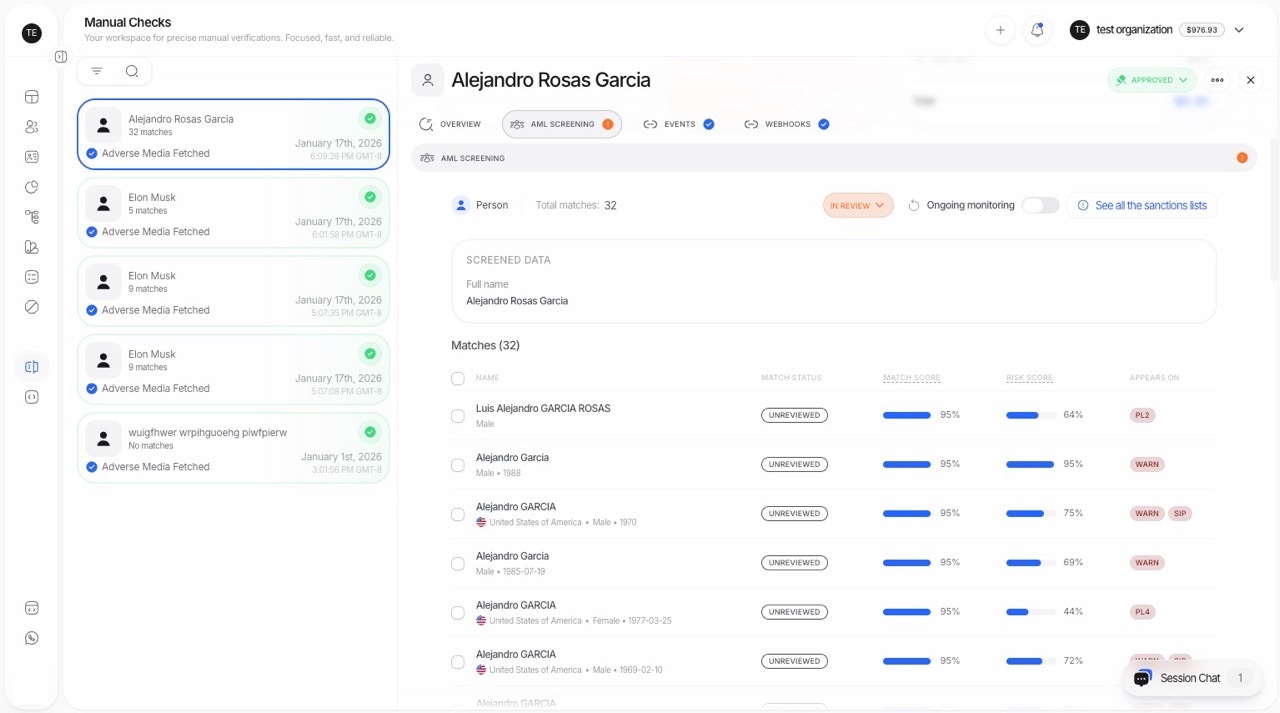
Concetti chiave: punteggio di corrispondenza vs punteggio di rischio
Didit utilizza un sistema a due punteggi per lo screening AML:Punteggio di corrispondenza (affidabilità dell’identità)
- Domanda: Questa corrispondenza riguarda la stessa persona sottoposta a screening?
- Fattori: Somiglianza del nome, data di nascita, paese/nazionalità, numero del documento
- Scopo: Classifica la corrispondenza come Falso positivo o Non esaminato (Possibile corrispondenza)
- Soglia: Soglia del punteggio di corrispondenza (predefinita: 93)
Punteggio di rischio (livello di rischio dell’entità)
- Domanda: Quanto è rischiosa questa entità se si tratta di una corrispondenza reale?
- Fattori: Rischio del paese, categoria (PEP/sanzioni/ecc.), precedenti penali
- Scopo: Determina lo stato AML finale (Approvato/In revisione/Rifiutato)
- Soglie: Soglia di approvazione (predefinita: 80) e soglia di revisione (predefinita: 100)
Stati di revisione delle corrispondenze
A ogni corrispondenza AML viene assegnato uno stato di revisione in base al relativo punteggio di corrispondenza:Suggerimento: Puoi modificare lo stato di revisione di una corrispondenza nella Console visualizzando la panoramica AML o cliccando su una corrispondenza specifica per visualizzarne i dettagli.
Funzionalità principali
1. Estrazione completa dei dati
- Estrazione accurata: estrai dati dalle informazioni fornite dall’utente o dai documenti d’identità utilizzando una tecnologia OCR avanzata.
- Logica fuzzy: gestisci varianti di nomi ed errori di battitura per garantire un’acquisizione completa dei dati.
2. Ampia copertura delle watchlist
Effettua lo screening su più categorie, tra cui:- Lista delle sanzioni: da enti governativi e internazionali.
- Persone politicamente esposte (PEP): individui con funzioni pubbliche di rilievo.
- Precedenti penali: inclusi database criminali globali e locali.
- Menzioni in notizie negative: articoli di giornale e report su reati finanziari e altri rischi.
- Watchlist personalizzate: configurabili in base alle esigenze specifiche del cliente.
3. Algoritmi di corrispondenza avanzati
- Corrispondenza fuzzy: rileva lievi variazioni nei nomi o nei dettagli per garantire una corrispondenza accurata.
- Molteplici punti dati: utilizza nome, data di nascita, nazionalità e altri identificatori per uno screening approfondito.
- Logica Golden Key: corrispondenza del numero di documento in grado di sovrascrivere i punteggi per un’identificazione definitiva.
4. Valutazione del rischio a due punteggi
Ogni corrispondenza riceve DUE punteggi:
Stato di revisione della corrispondenza (basato sul punteggio di corrispondenza):
- Falso positivo: punteggio di corrispondenza inferiore alla soglia: probabilmente NON si tratta della stessa persona
- Non revisionato: punteggio di corrispondenza pari o superiore alla soglia: richiede una revisione
- Approvata: tutte le corrispondenze non revisionate hanno punteggi di rischio bassi
- In revisione: almeno una corrispondenza non revisionata ha un punteggio di rischio medio-alto
- Rifiutata: almeno una corrispondenza non revisionata ha un punteggio di rischio molto elevato
5. Screening dettagliato delle notizie negative
Effettua lo screening su un’ampia gamma di categorie di notizie negative, tra cui:- Reati finanziari: riciclaggio di denaro, appropriazione indebita e altro.
- Reati violenti: aggressione, omicidio e reati correlati.
- Terrorismo: coinvolgimento o supporto ad attività terroristiche.
- Narcotici: traffico di stupefacenti e reati correlati.
- Frode: vari tipi di frode e pratiche ingannevoli.
- Violazioni normative: infrazioni dei requisiti di conformità normativa.
6. Parametri di screening personalizzabili
- Sensibilità regolabile: configura la sensibilità dello screening in base alla propensione al rischio della tua organizzazione.
- Watchlist personalizzabili: seleziona quali watchlist e categorie includere nel processo di screening per soddisfare requisiti specifici.
Soglie configurabili
Puoi personalizzare i livelli di sicurezza impostando soglie diverse: Configurazione del punteggio di corrispondenza:
Soglie del punteggio di rischio (stato finale):
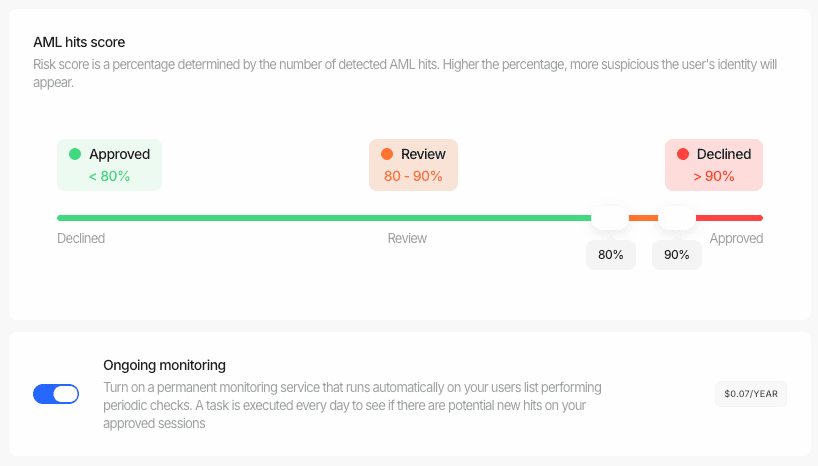
Queste soglie possono essere modificate in base alla tua tolleranza al rischio e ai tuoi requisiti di sicurezza.
Come funziona
Il nostro processo di Screening AML identifica in modo efficiente i potenziali rischi riducendo al minimo i ritardi per gli utenti legittimi.Estrazione dei dati
Il sistema estrae le informazioni rilevanti dai dati forniti dall’utente o dai documenti d’identità caricati.
Screening delle watchlist
I dati estratti vengono confrontati in tempo reale con 1,300+ watchlist globali e database:
- Liste delle sanzioni — Enti governativi e internazionali (OFAC, UE, ONU, ecc.)
- Persone politicamente esposte (PEP) — Persone che ricoprono cariche pubbliche di rilievo
- Precedenti penali — Database criminali globali e locali
- Notizie negative — Articoli di giornale e report su reati finanziari
- Watchlist personalizzate — Configurabili in base alle tue esigenze
Calcolo del punteggio di corrispondenza
Per ogni potenziale corrispondenza, il sistema calcola un punteggio di affidabilità dell’identità, che indica la probabilità che si tratti della stessa persona.
- Corrispondenza con un punteggio sotto la soglia (predefinito: 93) → classificata come Falso positivo
- Corrispondenza con un punteggio pari o superiore alla soglia → classificata come Non esaminata (possibile corrispondenza)
- Golden Key: la corrispondenza del numero del documento può sovrascrivere il punteggio al 100% per un’identificazione definitiva
Calcolo del punteggio di rischio
Per le corrispondenze non classificate come falsi positivi, il sistema calcola il livello di rischio dell’entità:
Determinazione dello stato finale
In base al punteggio di rischio più elevato tra tutte le corrispondenze non classificate come falsi positivi:
Se tutte le corrispondenze sono false positive, il risultato è Approvata (nessuna corrispondenza plausibile rilevata).
Generazione dei risultati
Viene generato un report dettagliato in totale trasparenza:
- Punteggio di corrispondenza e punteggio di rischio di ogni corrispondenza con dettaglio delle voci
- Classificazione delle corrispondenze (Falso positivo vs. Non esaminato vs. Confermato)
- Database di origine e dettagli della categoria per ciascun risultato
- Risultati inviati tramite risposta API, webhook o Business Console
- Processo decisionale automatico basato sulle soglie del punteggio di rischio configurate
AML Hit Data Reference
Ogni hit AML restituito nella risposta API contiene informazioni dettagliate sull’entità corrispondente. Di seguito sono riportati i campi principali e i loro possibili valori.Categorie di dataset
Il campodatasets di ciascun hit indica in quali categorie di database di compliance è stata trovata l’entità. Valori possibili:
Corrispondenze per sanzioni
L’arraysanction_matches contiene i dettagli per ciascuna lista delle sanzioni in cui è stata trovata l’entità. Campi principali:
Corrispondenze per avvisi
L’arraywarning_matches contiene i dettagli per le corrispondenze provenienti da liste di avvisi, di applicazione della normativa e correlate. Il campo additional_data può includere un array data.case_details con informazioni strutturate sul caso.
Tipologie di casi di avviso
Il campocase_type all’interno di additional_data.data.case_details[] descrive la natura del caso di avviso. Valori noti: