

 Começar
 Integrar / SDKs
 Verificação de utilizadores
 Verificação de empresas
 Monitorização de transações
 Registo de alterações
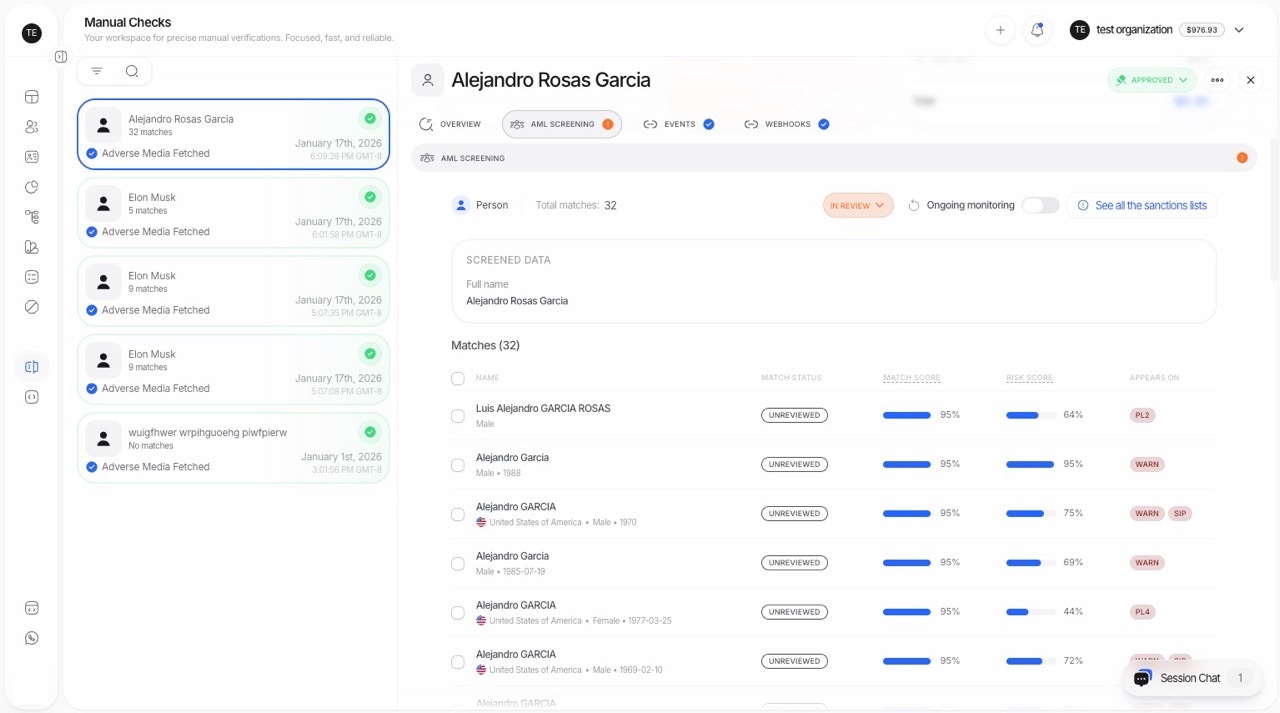
Conceitos-chave: pontuação de correspondência vs pontuação de risco
A Didit utiliza um sistema de duas pontuações para a triagem AML:Pontuação de correspondência (confiança na identidade)
- Pergunta: Esta correspondência é a mesma pessoa que estamos a verificar?
- Fatores: Semelhança do nome, data de nascimento, país/nacionalidade, número do documento
- Objetivo: Classifica a correspondência como Falso positivo ou Não revisto (correspondência possível)
- Limiar: Limiar da pontuação de correspondência (predefinição: 93)
Pontuação de risco (nível de risco da entidade)
- Pergunta: Quão arriscada é esta entidade se for uma correspondência real?
- Fatores: Risco do país, categoria (PEP/Sanções/etc.), registos criminais
- Objetivo: Determina o estado final de AML (Aprovada/Em análise/Recusada)
- Limiares: Limiar de aprovação (predefinição: 80) e Limiar de análise (predefinição: 100)
Estados de revisão da correspondência
A cada correspondência de AML é atribuído um estado de revisão com base na sua pontuação de correspondência:Dica: Pode alterar o estado de revisão de uma correspondência na Consola ao visualizar a visão geral de AML ou ao clicar numa correspondência específica para ver os seus detalhes.
Principais funcionalidades
1. Extração abrangente de dados
- Extração precisa: Extraia dados de informações fornecidas pelo utilizador ou de documentos de identidade através de tecnologia OCR avançada.
- Lógica difusa: Tenha em conta variações de nomes e erros ortográficos para garantir uma recolha de dados abrangente.
2. Cobertura alargada de listas de vigilância
Faça a triagem com base em múltiplas categorias, incluindo:- Listas de sanções: De organismos governamentais e internacionais.
- Pessoas politicamente expostas (PEPs): Indivíduos com cargos públicos de destaque.
- Registos criminais: Incluindo bases de dados criminais globais e locais.
- Menções em notícias adversas: Artigos de notícias e relatórios sobre crimes financeiros e outros riscos.
- Listas de vigilância personalizadas: Configuráveis com base nos requisitos específicos do cliente.
3. Algoritmos de correspondência avançados
- Correspondência difusa: Detete ligeiras variações em nomes ou dados para garantir uma correspondência precisa.
- Múltiplos pontos de dados: Utilize o nome, a data de nascimento, a nacionalidade e outros identificadores para uma triagem minuciosa.
- Lógica de chave mestra (Golden Key): Correspondência do número de documento que pode sobrepor-se às pontuações para uma identificação definitiva.
4. Avaliação de risco com duas pontuações
Cada correspondência recebe DUAS pontuações:
Estado de revisão da correspondência (com base na pontuação de correspondência):
- Falso positivo: Pontuação de correspondência abaixo do limiar - provavelmente NÃO é a mesma pessoa
- Não revista: Pontuação de correspondência igual ou superior ao limiar - requer revisão
- Aprovada: Todas as correspondências não revistas têm pontuações de risco baixas
- Em análise: Pelo menos uma correspondência não revista tem pontuação de risco média-alta
- Recusada: Pelo menos uma correspondência não revista tem pontuação de risco muito alta
5. Triagem detalhada de notícias adversas
Faça a triagem com base numa vasta gama de categorias de notícias adversas, incluindo:- Crimes financeiros: Branqueamento de capitais, peculato e muito mais.
- Crimes violentos: Agressão, homicídio e infrações relacionadas.
- Terrorismo: Envolvimento em ou apoio a atividades terroristas.
- Narcóticos: Tráfico de droga e crimes conexos.
- Fraude: Vários tipos de fraude e práticas enganosas.
- Violações regulamentares: Infrações a requisitos de conformidade regulamentar.
6. Parâmetros de triagem personalizáveis
- Sensibilidade ajustável: Configure a sensibilidade da triagem com base no apetite ao risco da sua organização.
- Listas de vigilância personalizáveis: Selecione quais as listas de vigilância e categorias a incluir no processo de triagem para cumprir requisitos específicos.
Limiares configuráveis
Pode personalizar os níveis de segurança configurando diferentes limiares: Configuração da pontuação de correspondência:
Limiares da pontuação de risco (estado final):
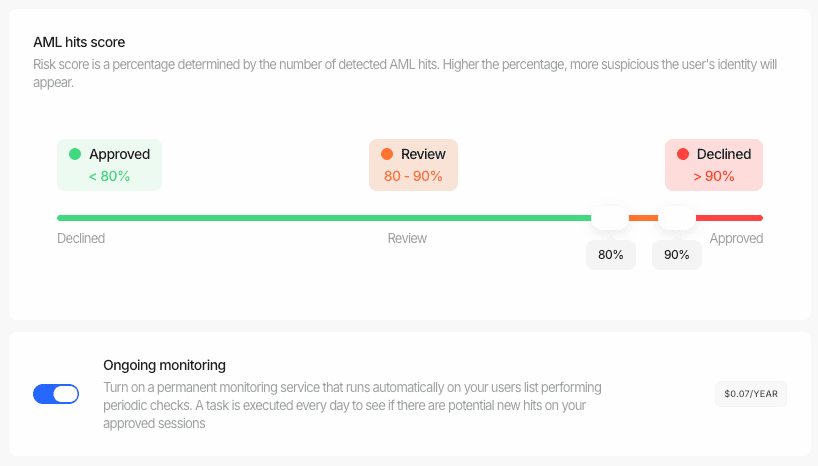
Estes limiares podem ser ajustados com base na sua tolerância ao risco e nos seus requisitos de segurança.
Como funciona
O nosso processo de Triagem AML identifica eficientemente potenciais riscos, minimizando em simultâneo os atrasos para utilizadores legítimos.Extração de dados
O sistema extrai informações relevantes a partir de dados fornecidos pelo utilizador ou de documentos de identidade carregados.
Triagem em listas de vigilância
Os dados extraídos são cruzados com 1,300+ listas de vigilância globais e bases de dados em tempo real:
- Listas de sanções — Organismos governamentais e internacionais (OFAC, UE, ONU, etc.)
- Pessoas politicamente expostas (PEPs) — Indivíduos com funções públicas de destaque
- Registos criminais — Bases de dados criminais globais e locais
- Notícias adversas — Artigos noticiosos e relatórios sobre crimes financeiros
- Listas de vigilância personalizadas — Configuráveis com base nos seus requisitos
Cálculo da pontuação de correspondência
Para cada correspondência potencial, o sistema calcula uma pontuação de confiança de identidade — a probabilidade de se tratar da mesma pessoa.
- Pontuação de correspondência abaixo do limiar (predefinição: 93) → a correspondência é classificada como falso positivo
- Pontuação de correspondência igual ou acima do limiar → a correspondência é classificada como não revista (possível correspondência)
- Chave Dourada: A correspondência do número do documento pode substituir a pontuação e defini-la como 100% para uma identificação definitiva
Cálculo da pontuação de risco
Para correspondências que não sejam falsos positivos, o sistema calcula o nível de risco da entidade:
Determinação do estado final
Com base na pontuação de risco mais elevada entre todas as correspondências que não sejam falsos positivos:
Se todas as correspondências forem falsos positivos, o resultado é Aprovada (nenhuma correspondência credível encontrada).
Geração do resultado
É gerado um relatório detalhado com total transparência:
- A pontuação de correspondência e a pontuação de risco de cada correspondência com detalhamento
- Classificação da correspondência (Falso positivo vs. Não revista vs. Confirmada)
- Base de dados de origem e detalhes da categoria para cada resultado
- Resultados entregues via resposta da API, webhook ou Business Console
- Tomada de decisão automática com base nos seus limiares de pontuação de risco configurados
Referência de dados de correspondências AML
Cada correspondência AML retornada na resposta da API contém informações detalhadas sobre a entidade correspondente. Abaixo encontram-se os principais campos e os seus valores possíveis.Categorias de conjuntos de dados
O campodatasets em cada correspondência indica em que categorias de bases de dados de conformidade a entidade foi encontrada. Valores possíveis:
Correspondências de sanções
O arraysanction_matches contém detalhes sobre cada lista de sanções em que a entidade foi encontrada. Campos principais:
Correspondências de avisos
O arraywarning_matches contém detalhes sobre correspondências provenientes de listas de avisos, medidas regulamentares e listas afins. O campo additional_data pode incluir um array data.case_details com informações estruturadas sobre o caso.
Tipos de casos de aviso
O campocase_type em additional_data.data.case_details[] descreve a natureza do caso de aviso. Valores conhecidos: