

 Начало работы
 Интеграция / SDK
 Проверка пользователей
 Верификация бизнеса
 Мониторинг транзакций
 Журнал изменений
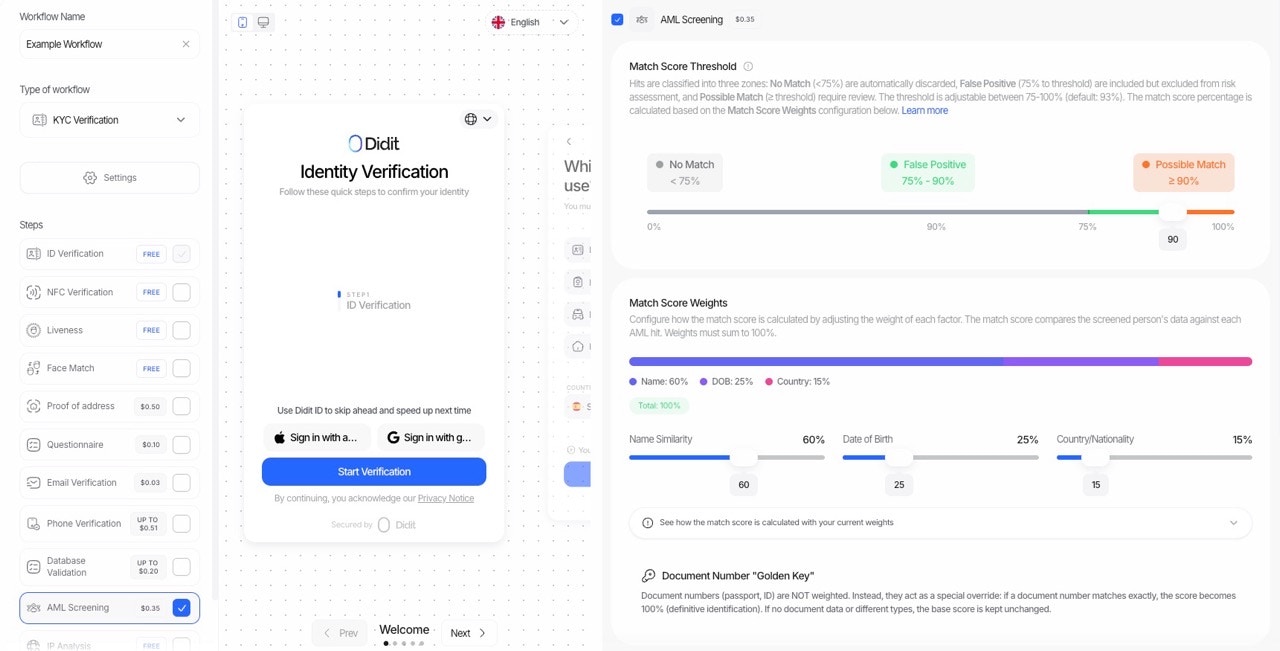
⚠️ Важно: Оценка совпадения определяет классификацию отдельного совпадения, а НЕ окончательный AML-статус. Окончательный AML-статус (одобрена / на проверке / отклонена) определяется оценкой риска для совпадений, не являющихся ложными срабатываниями.
Обзор
При проверке лица по спискам наблюдения AML каждое потенциальное совпадение получает оценку совпадения от 0 до 100. Эта оценка отвечает на вопрос: «Действительно ли это совпадение относится к проверяемому лицу?»Оценка совпадения и оценка риска
Как оценка совпадения определяет статус проверки
Каждое совпадение классифицируется на основе его оценки совпадения:Порог по умолчанию: 93%Пример: при пороге 93:
- Совпадение с оценкой 85 → Ложное срабатывание (автоматически исключается)
- Совпадение с оценкой 95 → Не проверено (требует проверки, оценка риска определяет срочность)
Описание статусов проверки
Все совпадения при AML-скрининге получают один из двух начальных статусов на основе их оценки совпадения:
После ручной проверки комплаенс-офицеры могут изменить статус на:
Совет: изменить статус проверки совпадения можно в консоли, открыв сводку AML или нажав на конкретное совпадение, чтобы просмотреть сведения о нём.
Как рассчитывается оценка совпадения
Шаг 1: Расчёт базовой оценки
Базовая оценка рассчитывается на основе трёх компонентов с настраиваемыми весами:Примечание: сумма весов всегда должна составлять 100%.
Шаг 2: Логика «золотого ключа» для номера документа
После расчёта базовой оценки номер документа оценивается отдельно с помощью специальной логики переопределения:
Такой подход исходит из того, что совпадение номера документа является окончательным подтверждением личности («золотой ключ»), тогда как несовпадающие типы документов не должны снижать оценку.
Детали скоринга компонентов
Сходство имён (0-100)
Для сопоставления имён используется алгоритм WRatio из RapidFuzz, устойчивый к:- Опечаткам и ошибкам в написании
- Различиям в порядке слов («John Smith» и «Smith, John»)
- Вариациям со вторым именем («Robert J. Smith» и «Robert James Smith»)
- Различиям в длине
Скоринг даты рождения
Важно: если в совпадении указан только год (например, «1974»), совпадение этого года считается полным совпадением, поскольку это вся доступная для проверки информация.
Скоринг страны/гражданства
Система автоматически преобразует:
- Коды ISO alpha-2 (ES)
- Коды ISO alpha-3 (ESP)
- Полные названия стран (Spain)
citizenship в дополнение к countries.
Нормализация оценок (перевзвешивание)
Если данные отсутствуют у проверяемого лица или в найденном совпадении, система использует нормализацию оценок, чтобы не снижать балл из-за недоступной информации.Пример: скрининг только по имени
Если вы проводите скрининг только по имени (без даты рождения и страны):
Результат: оценка имени становится итоговой оценкой совпадения.
Пример: отсутствие страны в совпадении
Если у найденного совпадения нет данных о стране, но есть дата рождения:
Это обеспечивает справедливую оценку независимо от полноты доступных данных.
Параметры конфигурации
Вы можете настроить расчёт оценки совпадения через API или в настройках сценария:Порог оценки совпадения
Веса (сумма должна составлять 100)
Пример запроса к API
Ответ: детализация оценки
Каждое совпадение в ответе содержит:match_score— рассчитанная оценка совпадения (0-100)risk_score— рассчитанная оценка риска (0-100) - см. Оценка рискаreview_status— «Ложное срабатывание» или «Не проверено» на основе порога оценки совпаденияscore_breakdown— подробная детализация расчёта оценки совпадения
Полный процесс: от оценки совпадения до итогового AML-статуса
Примеры расчёта
Пример 1: сильное совпадение → Не проверено
Проверяемые данные:- Имя: “Robert J. Smith”
- Дата рождения: “1985-03-15”
- Страна: “US”
- Имя: “Robert James Smith”
- Дата рождения: “1985”
- Страна: “United States”
- Оценка имени: 90% (нечёткое совпадение)
- Оценка даты рождения: 100% (в совпадении указан только год, год совпадает)
- Оценка страны: 100% (точное совпадение)
Пример 2: слабое совпадение → Ложное срабатывание
Проверяемые данные:- Имя: “John Smith”
- Дата рождения: “1990-05-20”
- Страна: “US”
- Имя: “Johnny Smithson”
- Дата рождения: “1975”
- Страна: “Canada”
- Оценка имени: 72% (слабое нечёткое совпадение)
- Оценка даты рождения: -100% (штраф за несовпадение года)
- Оценка страны: -50% (штраф за несовпадение страны)
Пример 3: переопределение по Golden Key
Проверяемые данные:- Имя: “John D. Smith”
- Номер документа: “A12345678”
- Имя: “Jonathan David Smith”
- Номер документа: “A12345678”
- Базовая оценка: ~70 (нечёткое совпадение имени)
- Номер документа: СОВПАДЕНИЕ (точное совпадение)
Управление статусом проверки
После первоначальной классификации вы можете вручную обновить статус проверки для каждого совпадения:В консоли
- Перейдите к AML-обзору сессии
- Нажмите на конкретное совпадение, чтобы просмотреть подробности
- Используйте выпадающий список статусов, чтобы изменить статус проверки:
- Подтверждённое совпадение — подтвердить, что это тот же человек
- Ложное срабатывание — отметить совпадение как ложное
- Не определено — невозможно определить
Рекомендации
- Начните с порога по умолчанию (93) — это обеспечивает хороший баланс между выявлением реальных совпадений и отсеиванием ложных срабатываний.
- Снижайте порог для сценариев с высоким риском — если требуется проявлять больше осторожности, снизьте порог оценки совпадения, чтобы выявлять больше потенциальных совпадений.
- Используйте номера документов при их наличии — они дают наиболее надёжное подтверждение личности и могут переопределять низкие оценки совпадения.
- Анализируйте нормализованные веса — проверяйте поля нормализованных весов в детализации оценки, чтобы понимать, как отсутствие данных повлияло на результат.
- Отслеживайте долю ложных срабатываний — если слишком много реальных совпадений помечаются как ложные срабатывания, снизьте порог.