

 はじめに
 連携 / SDK
 ユーザー認証
 法人確認
 トランザクションモニタリング
 変更履歴
⚠️ 重要: 一致スコアが決定するのは個々の一致の分類であり、最終的なAMLステータスではありません。最終的なAMLステータス(承認済み/レビュー中/却下)は、誤検知以外の一致のリスクスコアによって決まります。
概要
AMLウォッチリストと照合して人物をスクリーニングすると、各一致候補に0〜100の一致スコアが付与されます。このスコアは、「この一致は、スクリーニング対象者と本当に同一人物か」という問いに答えるものです。一致スコアとリスクスコアの違い
一致スコアによるレビューステータスの決定
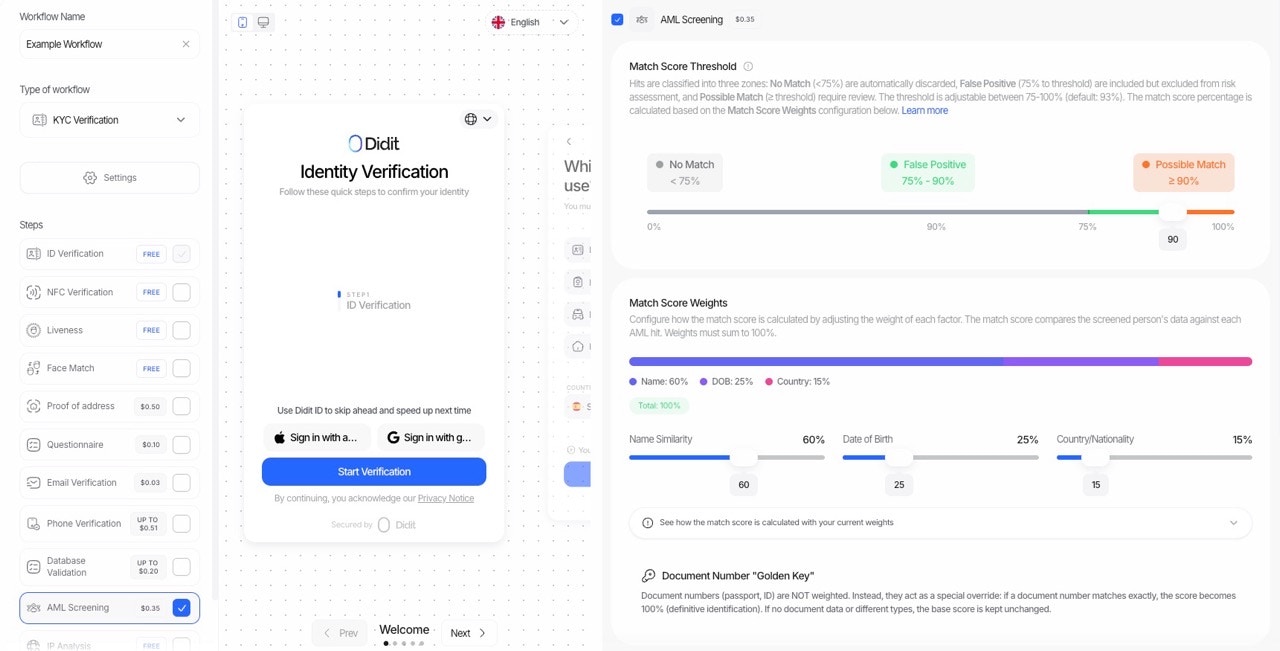
各一致は、一致スコアに基づいて分類されます。デフォルトのしきい値: 93%例: しきい値が93の場合
- スコア85の一致 → 誤検知(自動的に却下)
- スコア95の一致 → 未レビュー(レビューが必要で、リスクスコアによって緊急度が決まる)
レビューステータスの説明
すべてのAML一致は、一致スコアに基づいて2つの初期ステータスのいずれかから始まります。
手動レビューの後、コンプライアンス担当者はステータスを次のように更新できます。
ヒント: 一致のレビューステータスは、コンソールでAMLの概要を表示するか、特定の一致をクリックして詳細を開くことで変更できます。
一致スコアの計算方法
ステップ1: 基本スコアの計算
基本スコアは、重みを設定できる3つの要素を使って計算されます。注: 重みの合計は必ず100%にする必要があります。
ステップ2: 書類番号のゴールデンキーロジック
基本スコアを計算した後、書類番号は特別な上書きロジックを使って個別に評価されます。
この方式では、書類番号の一致を本人であることの決定的な証拠(ゴールデンキー)とみなす一方で、書類の種類が異なることによってスコアが減点されないようにしています。
コンポーネント別のスコアリング詳細
名前の類似度 (0-100)
名前の照合にはRapidFuzzのWRatioアルゴリズムを使用しており、次のような違いにも対応できます。- タイプミスや綴りの誤り
- 語順の違い (「John Smith」と「Smith, John」)
- ミドルネームの表記の違い (「Robert J. Smith」と「Robert James Smith」)
- 長さの違い
生年月日のスコアリング
重要: マッチ側が年のみ (例: 「1974」) を提供する場合、その年が一致すれば完全一致とみなされます。検証に利用できる情報がそれしかないためです。
国・国籍のスコアリング
システムは次の形式を自動的に相互変換します。
- ISO alpha-2コード (ES)
- ISO alpha-3コード (ESP)
- 国名のフル表記 (Spain)
countriesに加えてcitizenshipフィールドも確認します。
スコアの正規化 (再重み付け)
スクリーニング対象者とマッチのどちらかにデータが欠けている場合、システムはスコアの正規化を行い、入手できない情報によってスコアが不当に下がらないようにします。例: 名前のみのスクリーニング
名前のみ (生年月日や国なし) でスクリーニングした場合:
結果: 名前のスコアがそのまま一致スコア全体になります。
例: マッチ側に国の情報がない場合
マッチ側に国のデータはないものの生年月日がある場合:
これにより、データの有無にかかわらず公平なスコアリングが行われます。
設定オプション
一致スコアの計算は、APIまたはワークフローの設定でカスタマイズできます。一致スコアのしきい値
重み (合計が100である必要があります)
APIリクエストの例
レスポンス: スコアの内訳
レスポンス内の各マッチには次の項目が含まれます。match_score: 算出された一致スコア (0-100)risk_score: 算出されたリスクスコア (0-100)。詳しくはリスクスコアを参照してくださいreview_status: 一致スコアのしきい値に基づく「False Positive」または「Unreviewed」score_breakdown: 一致スコア計算の詳細な内訳
全体の流れ: 一致スコアから最終的なAMLステータスまで
計算例
例1: 強い一致 → 未レビュー
スクリーニング対象のデータ:- 氏名: “Robert J. Smith”
- 生年月日: “1985-03-15”
- 国: “US”
- 氏名: “Robert James Smith”
- 生年月日: “1985”
- 国: “United States”
- 氏名スコア: 90%(あいまい一致)
- 生年月日スコア: 100%(一致候補には年のみがあり、年が一致)
- 国スコア: 100%(完全一致)
例2: 弱い一致 → 誤検知
スクリーニング対象のデータ:- 氏名: “John Smith”
- 生年月日: “1990-05-20”
- 国: “US”
- 氏名: “Johnny Smithson”
- 生年月日: “1975”
- 国: “Canada”
- 氏名スコア: 72%(弱いあいまい一致)
- 生年月日スコア: -100%(年の不一致によるペナルティ)
- 国スコア: -50%(国の不一致によるペナルティ)
例3: ゴールデンキーによる上書き
スクリーニング対象のデータ:- 氏名: “John D. Smith”
- 書類番号: “A12345678”
- 氏名: “Jonathan David Smith”
- 書類番号: “A12345678”
- 基本スコア: 約70(氏名のあいまい一致)
- 書類番号: 一致(完全一致)
レビューステータスの管理
初回の分類後、各一致候補のレビューステータスを手動で更新できます。コンソールでの操作
- セッションのAML概要画面に移動します
- 対象の一致候補をクリックして詳細を表示します
- ステータスのドロップダウンでレビューステータスを変更します。
- 確認済み一致: 一致候補が同一人物であることを確認します
- 誤検知: 一致候補を不一致としてマークします
- 判断不能: 判断できない場合に使用します
ベストプラクティス
- デフォルトのしきい値(93)から始める: 真の一致の検出と誤検知の除外のバランスが適切に保たれます。
- リスクの高いケースではしきい値を下げる: より慎重な運用が必要な場合は、一致スコアのしきい値を下げて、一致の可能性がある候補をより多く検出します。
- 書類番号がある場合は活用する: 書類番号は最も強力な本人確認の根拠となり、低い一致スコアを上書きできます。
- 正規化された重みを確認する: スコア内訳の正規化された重みのフィールドを確認し、欠落データがスコアにどう影響したかを把握します。
- 誤検知率をモニタリングする: 正当な一致が誤検知として多くマークされている場合は、しきい値を下げてください。