

 はじめに
 連携 / SDK
 ユーザー認証
 法人確認
 トランザクションモニタリング
ライブネス検知の方式
Diditのプラットフォームは、セキュリティ要件とユーザー体験に合わせて使い分けられる、3種類のアンチスプーフィング技術を実装しています。| 方式 | 説明 | セキュリティレベル | 適した用途 |
|---|---|---|---|
3D Action & Flash | • 多要素の生体認証と、ランダムな動作シーケンスおよび動的な光パターン解析を組み合わせます。 • 開始時に、まばたきやうなずきなどの簡単な動作を求め、リアルタイムのやり取りを確認します。 • 同時に、顔に一連の光パターンを投影し、その反射を解析して顔の立体構造を確認します。 • ディープラーニングアルゴリズムが微表情と光の反射応答を調べ、生きた人物がいることを検証します。 • 行動(動作)と物理(光による奥行き)の手がかりを組み合わせるため、最高のセキュリティを実現し、静止画、動画、高度なマスクでさえなりすましはほぼ不可能です。 | 最高 | 銀行、医療、行政のアプリケーション |
3D Flash | • 動的な光パターン解析により、ユーザー操作なしで顔の立体形状を検証します。 • 毎秒30フレームを超える速度で一連の光パターンを顔に投影し、反射を解析して深度マップを作成します。 • この深度マップで顔の立体構造を確認し、平面の画像や2Dのなりすましと区別します。 • スムーズな体験を保ちながら、写真や画面などのプレゼンテーション攻撃に対して高いセキュリティを維持します。 | 高 | 金融サービス、アカウントアクセス、本人確認 |
Passive Liveness | • 1フレームのディープラーニング解析でライブネスの兆候を検出します。 • 画像のアーティファクトやテクスチャパターンなどの微妙な指標を調べ、本物の顔となりすましを区別します。 • 畳み込みニューラルネットワーク(CNN)が顔の特徴を検証し、印刷された写真やデジタル画面に由来する異常を特定します。 • 高速で便利な検証ですが、セキュリティは標準的で、低リスクのユースケースに適しています。 | 標準 | 摩擦の少ないシナリオ、一般消費者向けアプリケーション |
3D Flash と 3D Action & Flash の高度なセキュリティ:
- これらの方式は、高品質なマスク、ディープフェイク、動画の再生といった高度ななりすまし攻撃を退けるように設計されています。
- 動的な光パターンを投影してその反射を解析することで、光が本物の3Dの顔と、平面や人工物の表面とでどう異なる反応をするかを検出します。
- 3D Action & Flash方式は、ランダムな動作(例:まばたきやうなずき)で追加のセキュリティ層を設け、録画済みのメディアや合成されたアイデンティティでは再現できないリアルタイムの行動反応を必要とします。
- 高い精度と低い誤受入率が実証されており、これらの方式は重要度の高い環境に最適です。
設定可能なしきい値
ライブネススコアのしきい値を変えることで、セキュリティレベルをカスタマイズできます。例えば次のように設定します。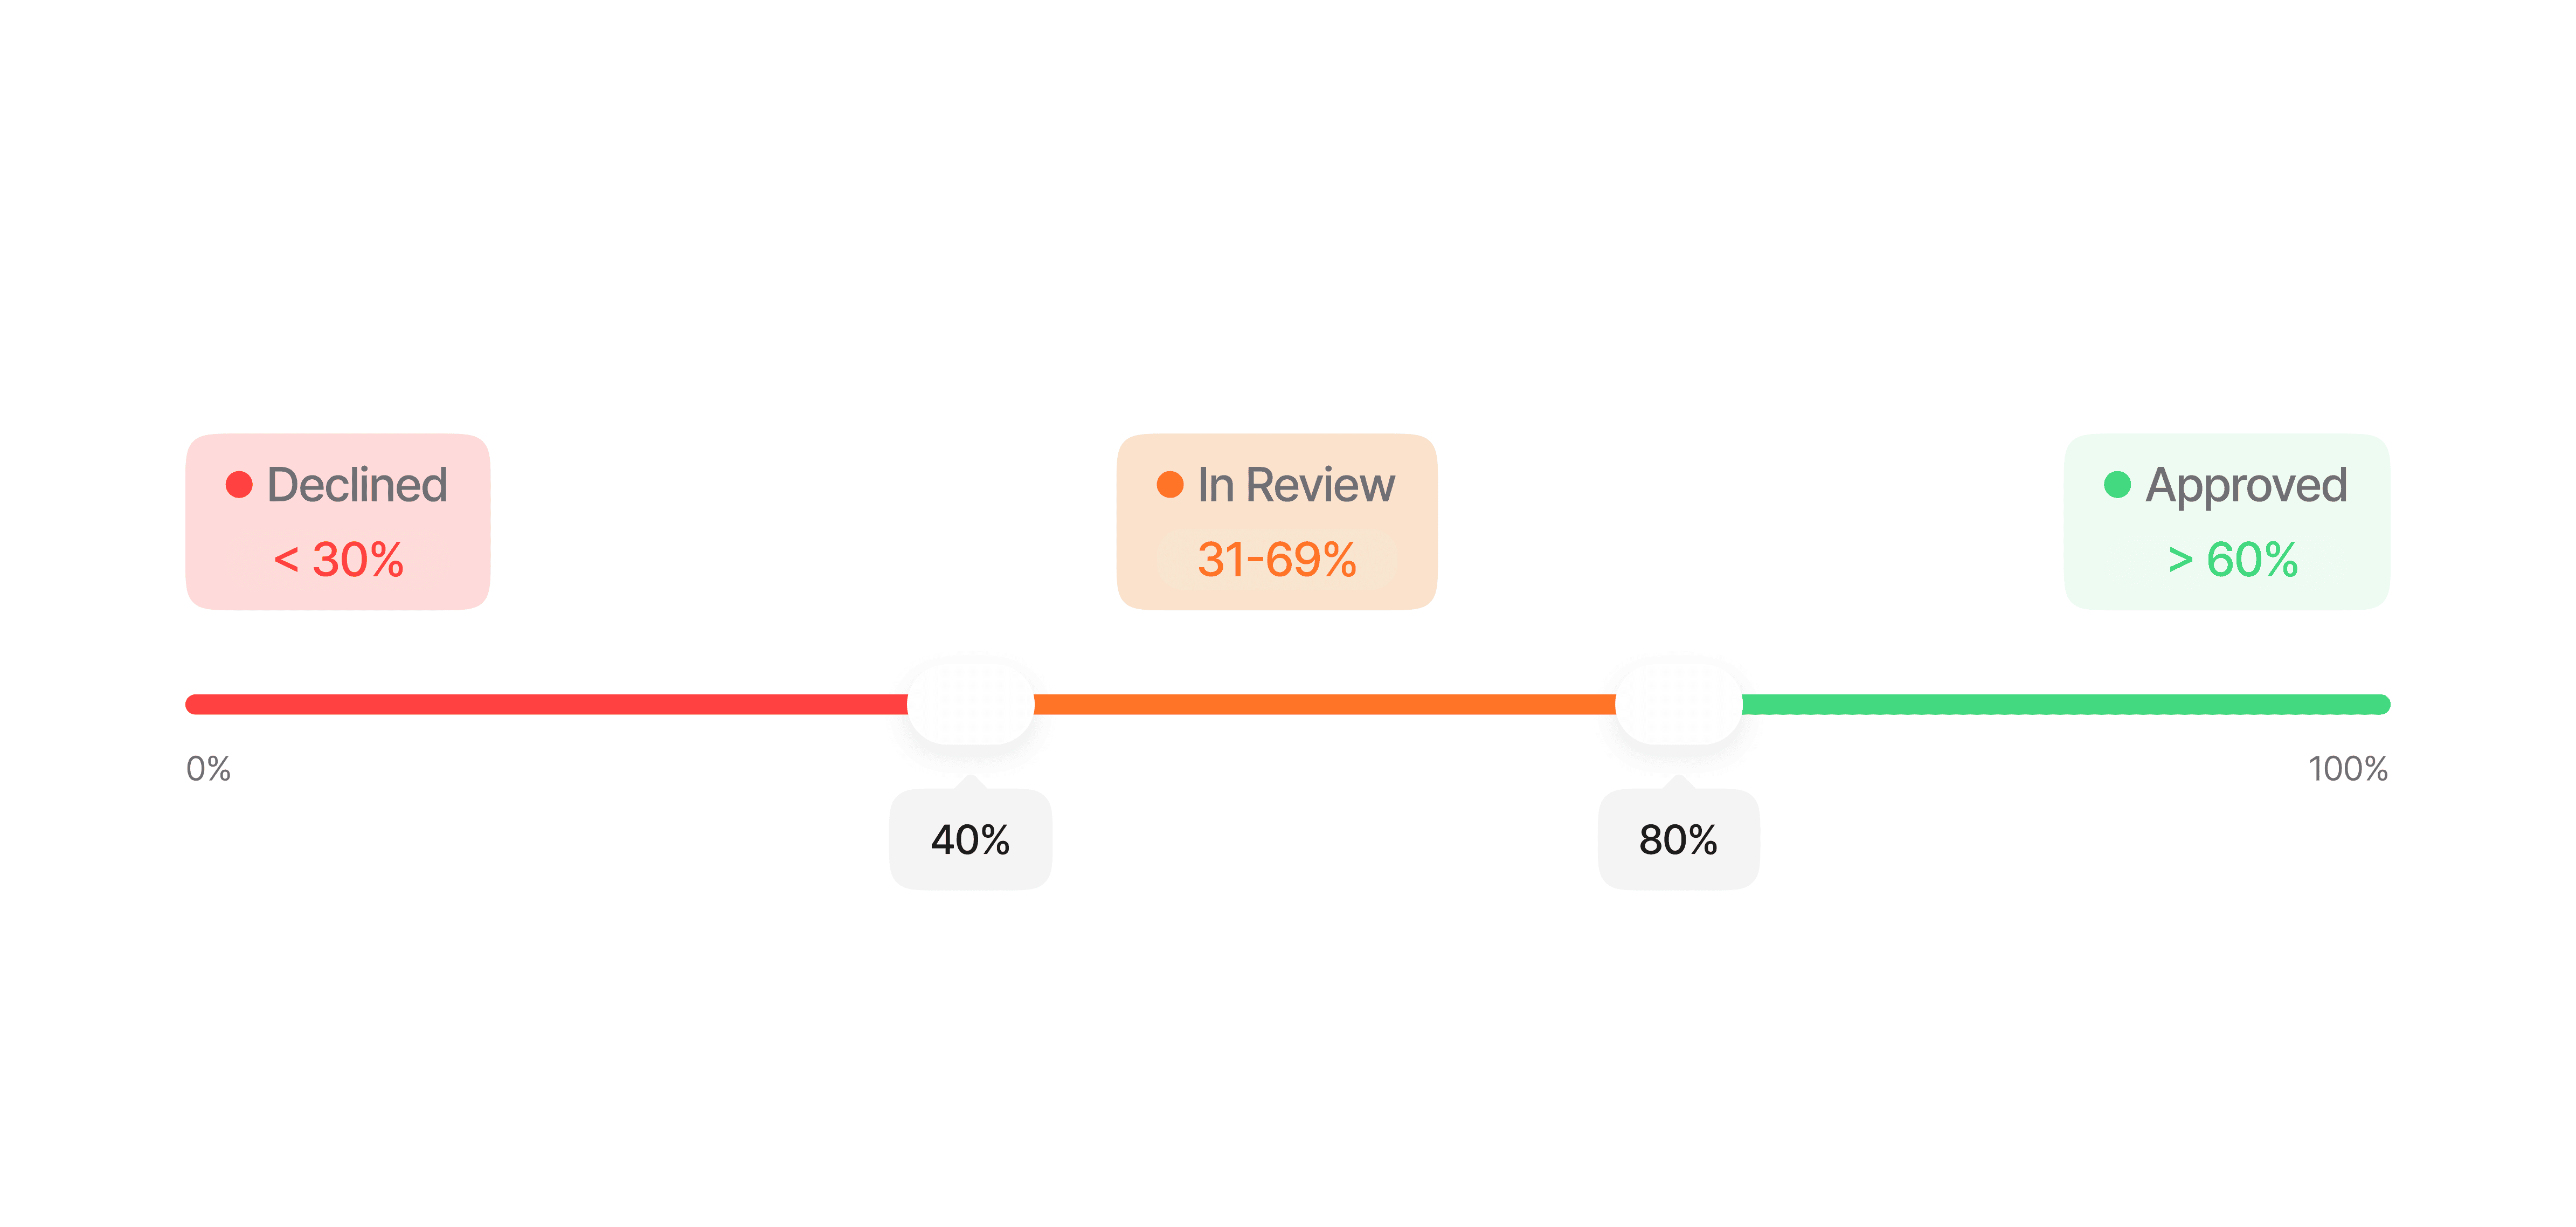
これらのしきい値は、リスク許容度とセキュリティ要件に合わせて調整でき、ユースケースを問わず柔軟に対応できます。
再試行と具体的なフィードバック
Diditのセッションでは、修正可能な理由(照明不足、顔が中央にない、遮蔽物、境界的なスコア)でライブネスの撮影に失敗しても、すぐには拒否されません。ユーザーは、設定可能な試行回数まで、具体的なガイダンスとともに再試行するよう求められます。-
試行回数の上限 —
face_liveness_max_attemptsは、1セッションあたりのライブネス送信の合計回数を制御します。既定は3(最初の1回と再試行2回)で、ワークフローのノードごとに設定できます(範囲は1〜3)。 -
再試行のフィードバック — 試行回数が残っている間、再試行可能な失敗ではユーザーはライブネスのステップにとどまり、具体的な
feedback_codesを含む本文が返されます(WebおよびモバイルSDKは、これを自動的にコーチングメッセージとして表示します)。 -
再試行可能なコード —
LOW_FACE_LUMINANCE(暗すぎる)、HIGH_FACE_LUMINANCE(明るすぎる)、NO_FACE_DETECTED、LOW_FACE_QUALITY、HIGH_FACE_OCCLUSION、LOW_LIVENESS_SCORE、MULTIPLE_FACES_DETECTED、AGE_NOT_DETECTED。 -
撮影条件での再試行の保証 —
LOW_FACE_LUMINANCE、HIGH_FACE_LUMINANCE、LOW_FACE_QUALITY、HIGH_FACE_OCCLUSION、NO_FACE_DETECTEDは、本人ではなく、ユーザーがいる環境の状態を表します。これらのコードだけで試行が失敗した場合、ワークフローがface_liveness_max_attempts: 1に設定されていても、ユーザーは上記のコーチングメッセージとともに必ず2回目の試行を行えます。それ以外のコードは、設定した試行回数の上限にそのまま従います。 -
上限到達と不正 — 試行回数の上限に達すると、算出されたステータス(
DeclinedまたはIn Review)が適用されます。確認されたプレゼンテーション攻撃(LIVENESS_FACE_ATTACK)、ブロックリストへのヒット、重複した顔は即座に拒否され、再試行はされません。
再試行はセッションフローにのみ適用されます。スタンドアロンの
POST /v3/passive-liveness/エンドポイントはステートレスで1回限りです。再試行の上限はなく、結果が直接返されます。仕組み
ビデオセルフィーの撮影
ユーザーは、選択されたライブネス方式に合わせたシンプルで直感的なインターフェースで案内されます。
ライブネス検知の解析
高度なアルゴリズムが、撮影したメディアをリアルタイムで処理し、なりすましの試みを検出します。解析内容は方式ごとに異なります。
多層的な検知により、写真、画面、マスク、ディープフェイクなどのプレゼンテーション攻撃を特定します。
3D Action & Flash
3D Action & Flash
- ユーザーの動作(例:まばたきやうなずき)が正しく、かつリアルタイムで行われたかを検証します
- 光パターンの反射を解析して、顔の立体構造を検証します
- ディープラーニングで微表情やその他の行動の手がかりを評価します
- 行動と物理の両方の信号を組み合わせ、最強のなりすまし耐性を実現します
3D Flash
3D Flash
- 30+ FPSで一連の光パターンの反射を処理し、詳細な深度マップを作成します
- 顔の3D特性を確認し、平面や2Dのなりすましと区別します
- ユーザー操作は不要で、ユーザーから見て完全にパッシブです
Passive Liveness
Passive Liveness
- 1フレームにディープラーニングを適用して、テクスチャパターンとアーティファクトを検出します
- 畳み込みニューラルネットワーク(CNN)が顔の特徴を検証し、異常を特定します
- 最速の方式で、写真1枚の撮影で動作します
結果の処理と検証
システムはライブネススコアを設定したしきい値と比較し、結果を即座に提供します。
結果はAPIレスポンス、Webhookで配信されるほか、コンプライアンス用の詳細な監査ログとともにBusiness Consoleでも確認できます。