

 はじめに
 連携 / SDK
 ユーザー認証
 法人確認
 トランザクションモニタリング
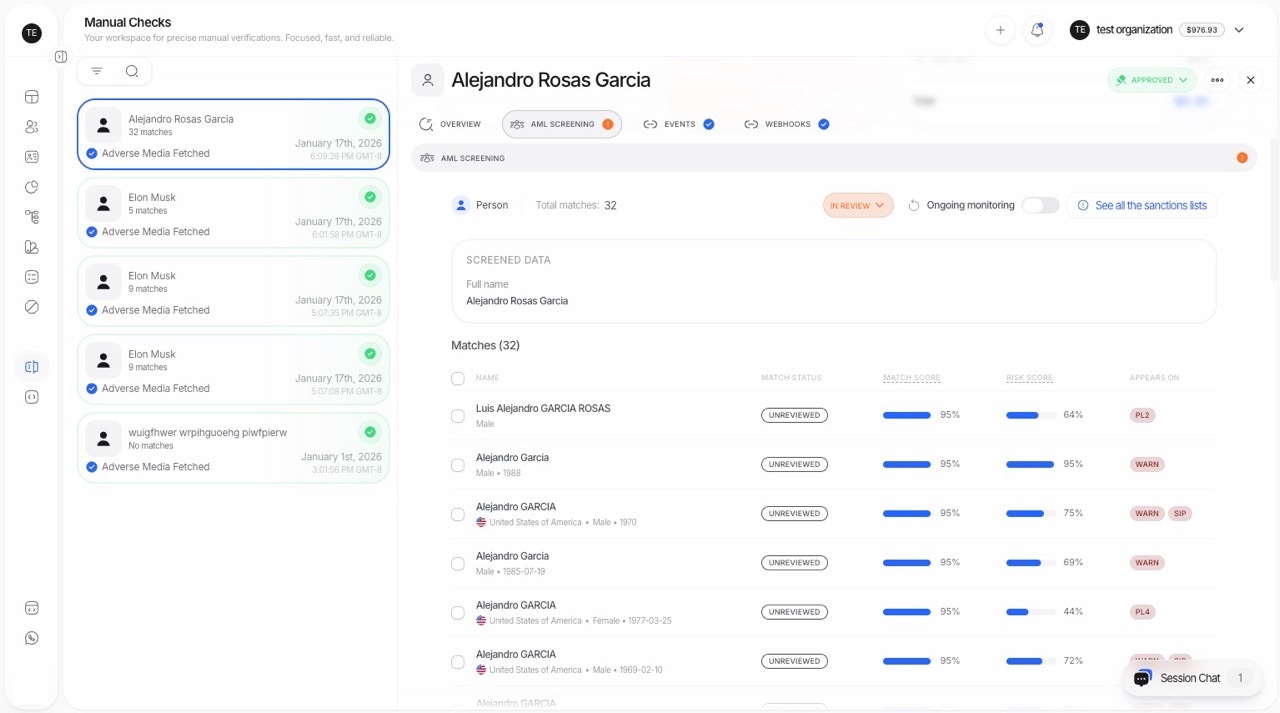
主な概念: マッチスコアとリスクスコア
DiditはAMLスクリーニングで2つのスコアによる方式を採用しています。マッチスコア(本人らしさ)
- 問い: この候補は、スクリーニング対象者と同一人物か?
- 要素: 氏名の類似度、生年月日、国・国籍、書類番号
- 目的: 候補を誤検知または未レビュー(可能性のある一致)に分類します
- しきい値: マッチスコアのしきい値(デフォルト: 93)
リスクスコア(エンティティのリスクレベル)
- 問い: 本当に一致していた場合、このエンティティはどれほど危険か?
- 要素: 国のリスク、カテゴリ(PEP/制裁など)、犯罪歴
- 目的: 最終的なAMLステータス(承認済み/審査中/拒否)を決定します
- しきい値: 承認しきい値(デフォルト: 80)とレビューしきい値(デフォルト: 100)
一致のレビューステータス
各AML候補には、マッチスコアに基づいてレビューステータスが割り当てられます。ヒント: コンソールでAMLの概要を表示するか、特定の一致をクリックして詳細を開くと、一致のレビューステータスを変更できます。
主な機能
1. 包括的なデータ抽出
- 高精度な抽出: 高度なOCR技術を使い、ユーザーが入力した情報や本人確認書類からデータを抽出します。
- あいまい照合: 氏名の表記ゆれやスペルミスを考慮し、漏れのないデータ取得を実現します。
2. 幅広いウォッチリストの網羅
次のようなカテゴリを横断してスクリーニングします。- 制裁リスト: 政府や国際機関が公表するもの。
- 重要な公的地位にある者(PEP): 公的に重要な職務に就いている人物。
- 犯罪歴: 世界各国および各地域の犯罪データベースを含みます。
- ネガティブメディアの言及: 金融犯罪やその他のリスクに関するニュース記事やレポート。
- カスタムウォッチリスト: お客様固有の要件に応じて設定できます。
3. 高度なマッチングアルゴリズム
- あいまいマッチング: 氏名や詳細情報のわずかな違いも捉え、正確に照合します。
- 複数のデータポイント: 氏名、生年月日、国籍、その他の識別情報を使って徹底的にスクリーニングします。
- ゴールデンキー ロジック: 書類番号の一致により、スコアを上書きして確定的に本人を特定できます。
4. 2つのスコアによるリスク評価
各一致には2つのスコアが付きます。
一致のレビューステータス(マッチスコアに基づく):
- 誤検知: マッチスコアがしきい値未満 - 同一人物ではない可能性が高い
- 未レビュー: マッチスコアがしきい値以上 - レビューが必要
- 承認済み: 未レビューの一致がすべて低いリスクスコア
- 審査中: 未レビューの一致のうち少なくとも1件が中〜高のリスクスコア
- 拒否: 未レビューの一致のうち少なくとも1件が非常に高いリスクスコア
5. 詳細なネガティブメディアスクリーニング
次のような幅広いネガティブメディアのカテゴリを対象にスクリーニングします。- 金融犯罪: マネーロンダリング、横領など。
- 暴力犯罪: 暴行、殺人、関連する犯罪。
- テロ: テロ活動への関与や支援。
- 麻薬: 薬物取引と関連する犯罪。
- 詐欺: さまざまな種類の詐欺や欺瞞行為。
- 規制違反: 規制上のコンプライアンス要件への違反。
6. スクリーニングパラメーターのカスタマイズ
- 感度の調整: 組織のリスク許容度に合わせてスクリーニングの感度を設定できます。
- ウォッチリストのカスタマイズ: 特定の要件に合わせて、スクリーニングに含めるウォッチリストとカテゴリを選択できます。
設定可能なしきい値
しきい値を変えることで、セキュリティレベルをカスタマイズできます。 マッチスコアの設定:
リスクスコアのしきい値(最終ステータス):
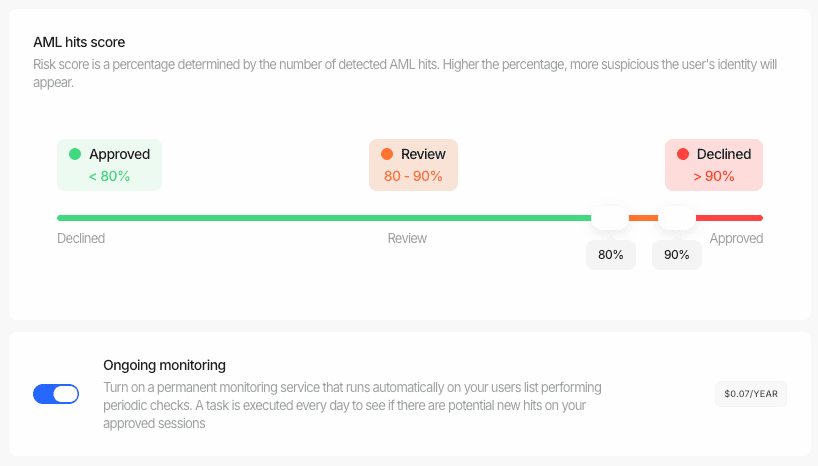
これらのしきい値は、リスク許容度やセキュリティ要件に応じて調整できます。
仕組み
DiditのAMLスクリーニングは、正当なユーザーの待ち時間を最小限に抑えながら、潜在的なリスクを効率的に特定します。データの抽出
システムは、ユーザーが入力したデータまたはアップロードされた本人確認書類から、関連する情報を抽出します。
ウォッチリストのスクリーニング
抽出したデータを、1,300+の世界のウォッチリストとデータベースに対してリアルタイムで照合します。
- 制裁リスト — 政府および国際機関(OFAC、EU、国連など)
- 重要な公的地位にある者(PEP) — 公的に重要な職務に就いている人物
- 犯罪歴 — 世界各国および各地域の犯罪データベース
- ネガティブメディア — 金融犯罪に関するニュース記事やレポート
- カスタムウォッチリスト — 要件に応じて設定可能
マッチスコアの計算
見つかった候補ごとに、同一人物である可能性を示す本人らしさのスコアを計算します。
- マッチスコアがしきい値未満(デフォルト: 93) → 誤検知に分類
- マッチスコアがしきい値以上 → 未レビュー(可能性のある一致)に分類
- ゴールデンキー: 書類番号が一致した場合は100%に上書きして、確定的に本人を特定できます
リスクスコアの計算
誤検知ではない一致について、システムはそのエンティティのリスクレベルを計算します。
最終ステータスの決定
誤検知ではないすべての一致のうち、最も高いリスクスコアに基づいて決定します。
すべての一致が誤検知の場合、結果は承認済みになります(信頼できる一致は見つかりませんでした)。
結果の生成
透明性の高い詳細なレポートが生成されます。
- 各一致のマッチスコアとリスクスコア、およびその内訳
- 一致の分類(誤検知、未レビュー、確認済みなど)
- 各ヒットの情報源データベースとカテゴリの詳細
- 結果はAPIレスポンス、Webhook、ビジネスコンソールで提供
- 設定したリスクスコアのしきい値に基づく自動判定
AMLヒットデータのリファレンス
APIレスポンスで返される各AMLヒットには、一致したエンティティの詳細情報が含まれます。主なフィールドと取り得る値は次のとおりです。データセットのカテゴリ
各ヒットのdatasetsフィールドは、そのエンティティが見つかったコンプライアンスデータベースのカテゴリを示します。取り得る値は次のとおりです。
制裁の一致
sanction_matches配列には、そのエンティティが見つかった制裁リストごとの詳細が含まれます。主なフィールドは次のとおりです。
警告の一致
warning_matches配列には、警告、規制上の執行措置、関連リストからの一致の詳細が含まれます。additional_dataフィールドには、構造化された案件情報を持つdata.case_details配列が含まれる場合があります。
警告案件の種類
additional_data.data.case_details[]内のcase_typeフィールドは、警告案件の性質を示します。既知の値は次のとおりです。