

 시작하기
 연동 / SDK
 사용자 인증
 기업 확인
 거래 모니터링
 변경 내역
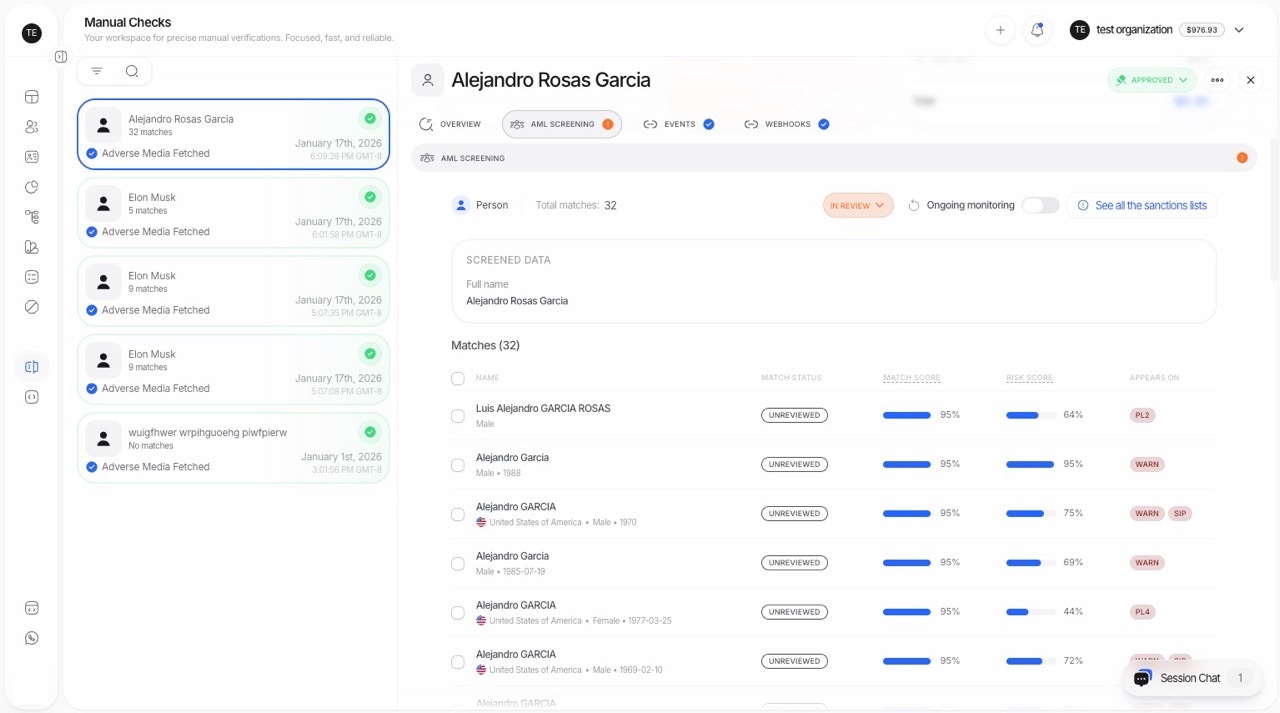
주요 개념: 일치 점수 vs 위험 점수
Didit은 AML 스크리닝에 2중 점수 시스템을 사용합니다:일치 점수 (신원 신뢰도)
- 질문: 이 일치 항목이 스크리닝 중인 대상자와 동일 인물인가?
- 요소: 이름 유사도, 생년월일, 국가/국적, 문서 번호
- 목적: 일치 항목을 오탐 또는 검토 안 됨(일치 가능성 있음)으로 분류
- 임계값: 일치 점수 임계값(기본값: 93)
위험 점수 (엔티티 위험 수준)
- 질문: 실제 일치 항목인 경우 이 엔티티는 얼마나 위험한가?
- 요소: 국가 위험도, 카테고리(PEP/제재 등), 범죄 기록
- 목적: 최종 AML 상태(승인됨/검토 중/거부됨) 결정
- 임계값: 승인 임계값(기본값: 80) 및 검토 임계값(기본값: 100)
일치 검토 상태
각 AML 일치 항목에는 일치 점수를 기반으로 검토 상태가 할당됩니다:팁: 콘솔에서 AML 개요를 확인하거나 특정 일치 항목을 클릭하여 세부 정보를 확인해 일치 검토 상태를 변경할 수 있습니다.
주요 기능
1. 종합적인 데이터 추출
- 정확한 추출: 고급 OCR 기술을 사용하여 사용자가 제공한 정보나 신분증 문서에서 데이터를 추출합니다.
- 퍼지 로직: 이름 변형 및 철자 오류를 고려하여 데이터를 빠짐없이 수집합니다.
2. 광범위한 감시 목록 적용 범위
다음을 포함한 여러 범주를 대상으로 스크리닝합니다.- 제재 목록: 정부 및 국제 기관의 목록입니다.
- 정치적 주요 인물(PEP): 주요 공직을 맡고 있는 개인입니다.
- 범죄 기록: 글로벌 및 현지 범죄 데이터베이스를 포함합니다.
- 부정적 언론 보도: 금융 범죄 및 기타 위험에 관한 뉴스 기사 및 보도입니다.
- 맞춤형 감시 목록: 고객의 특정 요구 사항에 따라 구성할 수 있습니다.
3. 고급 일치 알고리즘
- 퍼지 매칭: 이름이나 세부 정보의 미세한 변형을 포착하여 정확한 일치를 보장합니다.
- 다양한 데이터 요소: 철저한 스크리닝을 위해 성명, 생년월일, 국적 및 기타 식별자를 활용합니다.
- 골든 키 로직: 확실한 식별을 위해 점수보다 우선 적용될 수 있는 문서 번호 매칭입니다.
4. 2개 점수 기반 위험 평가
각 일치 항목은 두 가지 점수를 받습니다.
일치 검토 상태 (일치 점수 기준):
- 오탐: 일치 점수가 임계값 미만 - 동일 인물이 아닐 가능성이 높음
- 미검토: 일치 점수가 임계값 이상 - 검토 필요
- 승인됨: 미검토 상태의 모든 일치 항목의 위험 점수가 낮음
- 검토 중: 미검토 상태의 일치 항목 중 하나 이상의 위험 점수가 중간 또는 높음
- 거부됨: 미검토 상태의 일치 항목 중 하나 이상의 위험 점수가 매우 높음
5. 상세한 부정적 언론 보도 스크리닝
다음을 포함한 광범위한 부정적 언론 보도 범주를 대상으로 스크리닝합니다.- 금융 범죄: 자금 세탁, 횡령 등.
- 폭력 범죄: 폭행, 살인 및 관련 범죄.
- 테러: 테러 활동 가담 또는 지원.
- 마약: 마약 밀매 및 관련 범죄.
- 사기: 다양한 유형의 사기 및 기만 행위.
- 규제 위반: 규제 준수 요건 위반.
6. 맞춤형 스크리닝 파라미터
- 민감도 조정: 조직의 위험 감수 성향에 따라 스크리닝 민감도를 구성합니다.
- 맞춤형 감시 목록: 특정 요구 사항을 충족하기 위해 스크리닝 프로세스에 포함할 감시 목록과 범주를 선택합니다.
구성 가능한 임계값
다양한 임계값을 설정하여 보안 수준을 맞춤 조정할 수 있습니다. 일치 점수 구성:
위험 점수 임계값 (최종 상태):
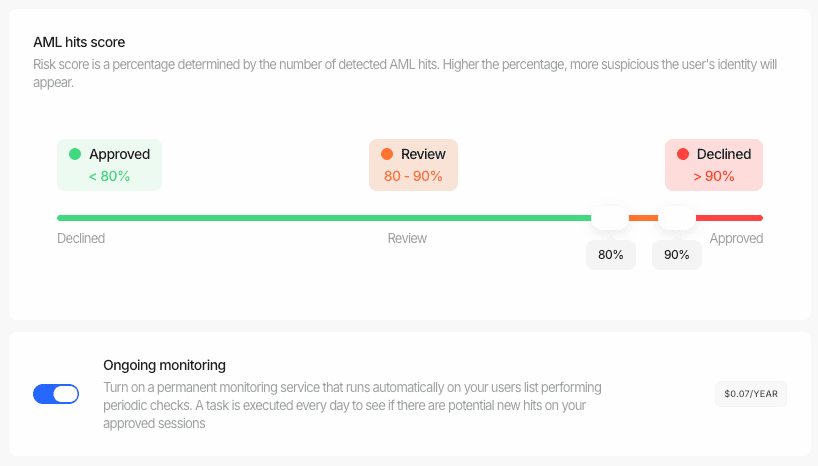
이러한 임계값은 조직의 위험 허용 범위와 보안 요구 사항에 따라 조정할 수 있습니다.
작동 방식
AML 스크리닝 프로세스는 정상적인 사용자의 대기 시간을 최소화하면서 잠재적 위험을 효율적으로 식별합니다.데이터 추출
시스템은 사용자가 제공한 데이터 또는 업로드된 신분증 서류에서 관련 정보를 추출합니다.
감시 목록 스크리닝
추출된 데이터를 1,300+개 글로벌 감시 목록 및 데이터베이스와 실시간으로 교차 검증합니다:
- 제재 목록 — 정부 및 국제기구(OFAC, EU, UN 등)
- 정치적 주요 인물(PEP) — 주요 공적 역할을 맡은 개인
- 범죄 기록 — 글로벌 및 로컬 범죄 데이터베이스
- 부정적 언론 보도 — 금융 범죄 관련 뉴스 기사 및 보고서
- 맞춤형 감시 목록 — 요구사항에 맞게 구성 가능
일치 점수 계산
잠재적 일치 건마다 시스템이 신원 신뢰도 점수(동일인일 확률)를 계산합니다.
- 일치 점수 임계값 미만(기본값: 93) → 오탐으로 분류
- 일치 점수 임계값 이상 → 미검토(일치 가능성 있음)로 분류
- 골든 키: 확실한 식별을 위해 문서 번호 일치 시 100%로 덮어쓸 수 있음
위험 점수 계산
오탐이 아닌 일치 건에 대해 시스템이 해당 주체의 위험 수준을 계산합니다:
최종 상태 결정
오탐이 아닌 모든 일치 건 중 가장 높은 위험 점수를 기준으로 결정합니다:
전체 일치 건이 오탐인 경우, 결과는 승인됨(신뢰할 만한 일치 항목 없음)입니다.
결과 생성
완전한 투명성을 갖춘 상세 보고서가 생성됩니다:
- 각 일치 항목의 세부 내역이 포함된 일치 점수 및 위험 점수
- 일치 분류(오탐 vs. 미검토 vs. 확인됨)
- 적발된 모든 건에 대한 소스 데이터베이스 및 카테고리 세부정보
- API 응답, webhook 또는 Business Console을 통한 결과 전송
- 설정된 위험 점수 임계값에 기반한 자동 결정
AML 일치 데이터 레퍼런스
API 응답으로 반환되는 각 AML 일치 항목에는 일치하는 개체에 대한 상세 정보가 포함되어 있습니다. 아래는 주요 필드와 해당 필드의 사용 가능한 값입니다.데이터셋 카테고리
각 일치 항목의datasets 필드는 해당 개체가 어떤 컴플라이언스 데이터베이스 카테고리에서 발견되었는지를 나타냅니다. 가능한 값은 다음과 같습니다.
제재 일치 항목
sanction_matches 배열에는 개체가 발견된 각 제재 목록에 대한 세부 정보가 포함되어 있습니다. 주요 필드는 다음과 같습니다.
경고 일치 항목
warning_matches 배열에는 경고, 규제 집행 및 관련 목록의 일치 세부 정보가 포함되어 있습니다. additional_data 필드에는 구조화된 케이스 정보가 포함된 data.case_details 배열이 포함될 수 있습니다.
경고 케이스 유형
additional_data.data.case_details[] 내의 case_type 필드는 경고 케이스의 성격을 설명합니다. 알려진 값은 다음과 같습니다.