

 시작하기
 연동 / SDK
 사용자 인증
 기업 확인
 거래 모니터링
 변경 내역
⚠️ 중요: 일치 점수는 최종 AML 상태가 아닌 개별 일치 항목 분류를 결정합니다. 최종 AML 상태(승인됨/검토 중/거부됨)는 오탐이 아닌 일치 항목의 위험 점수에 따라 결정됩니다.
개요
AML 감시 목록을 대상으로 개인을 스크리닝할 때, 각 잠재적 일치 항목은 0-100점의 일치 점수를 받습니다. 이 점수는 “이 일치 항목이 실제로 스크리닝 중인 대상자와 동일 인물인가?”라는 질문에 답합니다.일치 점수 대 위험 점수
일치 점수가 검토 상태를 결정하는 방식
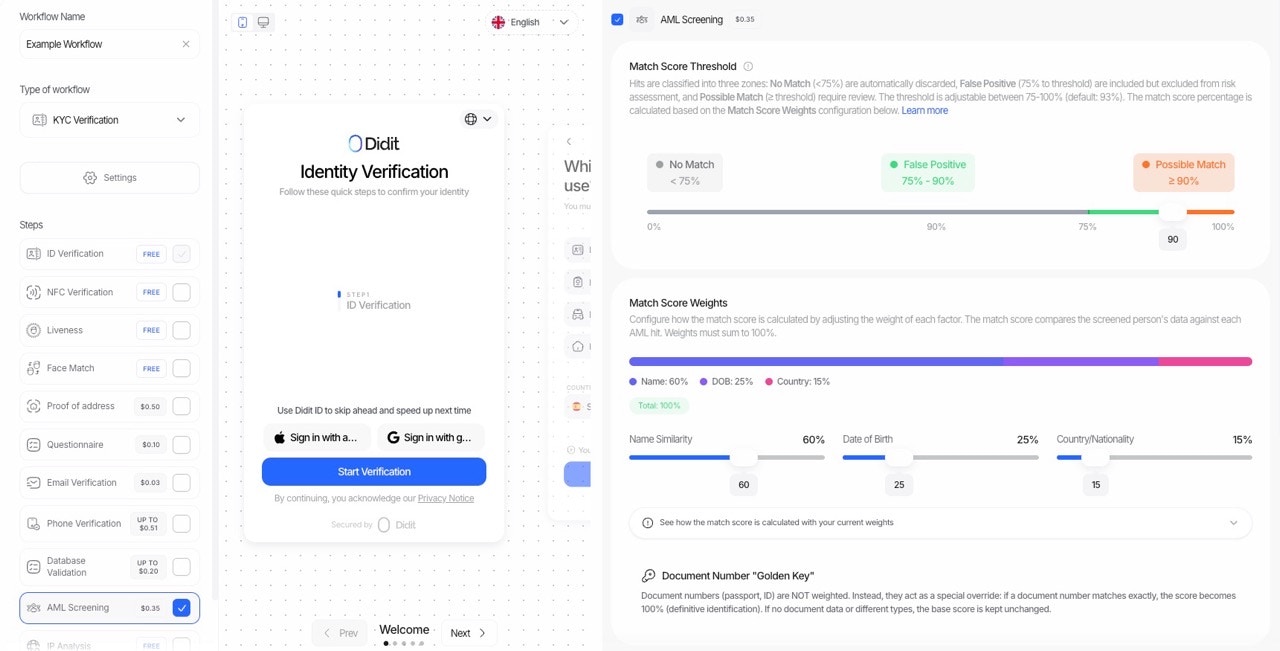
각 일치 항목은 일치 점수를 기반으로 분류됩니다.기본 임계값: 93%예시: 임계값이 93인 경우:
- 점수 85인 일치 항목 → 오탐 (자동 기각)
- 점수 95인 일치 항목 → 미검토 (검토 필요, 위험 점수로 긴급도 결정)
검토 상태 상세 설명
모든 AML 일치 항목은 일치 점수를 기반으로 두 가지 초기 상태 중 하나로 시작합니다.
수동 검토 후 컴플라이언스 담당자는 상태를 다음과 같이 업데이트할 수 있습니다.
팁: Console에서 AML 개요를 확인하거나 특정 일치 항목을 클릭하여 세부 정보를 확인하는 방식으로 일치 항목의 검토 상태를 변경할 수 있습니다.
일치 점수 계산 방식
1단계: 기본 점수 계산
기본 점수는 가중치를 구성할 수 있는 세 가지 구성 요소를 사용하여 계산됩니다.참고: 가중치의 합은 항상 100%여야 합니다.
2단계: 문서 번호 “골든 키” 로직
기본 점수를 계산한 후, 특수 재정의 로직을 사용하여 문서 번호를 별도로 평가합니다.
이 방식은 일치하는 문서 번호가 신원에 대한 결정적인 증거(“골든 키”)라는 점을 인정하면서도, 서로 일치하지 않는 문서 유형이 점수에 불이익을 주지 않도록 합니다.
구성 요소별 점수 산정 세부사항
이름 유사도 (0-100)
이름 매칭에는 RapidFuzz의 WRatio 알고리즘을 사용하며, 다음 항목에 대해 강력한 성능을 발휘합니다.- 오타 및 철자 오류
- 어순 차이 (“John Smith” vs “Smith, John”)
- 중간 이름 표기 차이 (“Robert J. Smith” vs “Robert James Smith”)
- 글자 수 차이
생년월일 점수 산정
중요: 매치 대상에 연도만 제공되는 경우(예: “1974”), 확인할 수 있는 정보가 그것뿐이므로 해당 연도가 일치하면 완전한 일치로 처리됩니다.
국가 및 국적 점수 산정
시스템은 다음 형식 간의 변환을 자동으로 처리합니다.
- ISO alpha-2 코드 (ES)
- ISO alpha-3 코드 (ESP)
- 전체 국가명 (Spain)
countries 필드 외에 citizenship 필드도 함께 확인합니다.
점수 정규화 (가중치 재산정)
스크리닝 대상자 또는 매치 대상 중 한쪽에 데이터가 누락된 경우, 시스템은 확인할 수 없는 정보로 인한 불이익을 방지하기 위해 점수 정규화를 적용합니다.예시: 이름만 스크리닝하는 경우
생년월일이나 국가 없이 이름만으로 스크리닝하는 경우:
결과: 이름 점수가 전체 일치 점수가 됩니다.
예시: 매치 대상에 국가 정보가 누락된 경우
매치 대상에 국가 데이터는 없지만 생년월일은 있는 경우:
이를 통해 데이터 제공 여부와 관계없이 공정한 점수 산정이 이루어집니다.
설정 옵션
API 또는 워크플로 설정을 통해 일치 점수 계산 방식을 맞춤 설정할 수 있습니다.일치 점수 임계값
가중치 (합계가 100이어야 함)
API 요청 예시
응답: 점수 세부 분석
응답의 각 매치 항목에는 다음 정보가 포함됩니다.match_score— 계산된 일치 점수 (0-100)risk_score— 계산된 위험 점수 (0-100) - 위험 점수 참고review_status— 일치 점수 임계값을 기반으로 한 “False Positive” 또는 “Unreviewed”score_breakdown— 일치 점수 계산의 상세 분석
전체 흐름: 일치 점수부터 최종 AML 상태까지
계산 예시
예시 1: 강한 일치 → 미검토
스크리닝된 데이터:- 이름: “Robert J. Smith”
- 생년월일: “1985-03-15”
- 국가: “US”
- 이름: “Robert James Smith”
- 생년월일: “1985”
- 국가: “United States”
- 이름 점수: 90% (퍼지 일치)
- 생년월일 점수: 100% (일치 데이터에 연도만 있으며, 연도가 일치함)
- 국가 점수: 100% (정확히 일치)
예시 2: 약한 일치 → 오탐
스크리닝된 데이터:- 이름: “John Smith”
- 생년월일: “1990-05-20”
- 국가: “US”
- 이름: “Johnny Smithson”
- 생년월일: “1975”
- 국가: “Canada”
- 이름 점수: 72% (약한 퍼지 일치)
- 생년월일 점수: -100% (연도 불일치 감점)
- 국가 점수: -50% (국가 불일치 감점)
예시 3: 골든 키 재정의
스크리닝된 데이터:- 이름: “John D. Smith”
- 문서 번호: “A12345678”
- 이름: “Jonathan David Smith”
- 문서 번호: “A12345678”
- 기본 점수: ~70 (이름 퍼지 일치)
- 문서 번호: 일치 (정확히 일치)
검토 상태 관리
초기 분류 후 각 일치 항목의 검토 상태를 수동으로 업데이트할 수 있습니다:콘솔에서
- 세션의 AML 개요로 이동합니다
- 특정 일치 항목을 클릭하여 세부 정보를 확인합니다
- 상태 드롭다운을 사용하여 검토 상태를 변경합니다:
- 확인된 일치 — 일치 항목이 동일 인물임을 확인
- 오탐 — 일치 항목을 일치하지 않는 것으로 표시
- 판단 불가 — 판단할 수 없음
모범 사례
- 기본 임계값(93)으로 시작 — 실제 일치 항목 포착과 오탐 필터링 간의 우수한 균형을 제공합니다.
- 고위험 시나리오의 경우 임계값 낮추기 — 더 신중해야 하는 경우, 일치 점수 임계값을 낮춰 더 많은 잠재적 일치 항목을 포착하십시오.
- 가능한 경우 문서 번호 사용 — 가장 강력한 신원 확인을 제공하며 낮은 일치 점수를 재정의할 수 있습니다.
- 정규화된 가중치 검토 — 점수 분석에서 정규화된 가중치 필드를 확인하여 누락된 데이터가 점수에 어떤 영향을 미쳤는지 파악하십시오.
- 오탐율 모니터링 — 정당한 일치 항목이 오탐으로 너무 많이 표시되는 경우 임계값을 낮추십시오.