

 Primeiros passos
 Integração / SDKs
 Verificação de usuários
 Verificação de empresas
 Monitoramento de transações
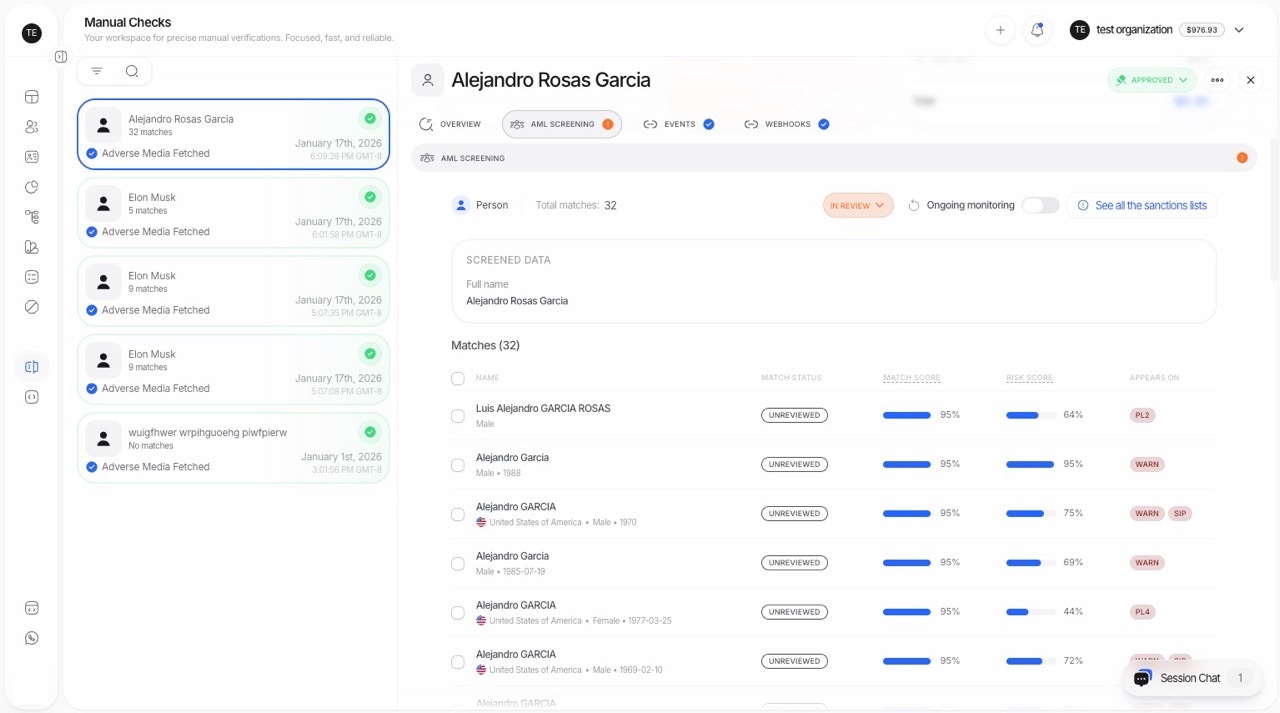
Conceitos-chave: pontuação de correspondência vs. pontuação de risco
A Didit usa um sistema de duas pontuações na análise AML:Pontuação de correspondência (confiança na identidade)
- Pergunta: esta correspondência é a mesma pessoa que estamos analisando?
- Fatores: similaridade de nome, data de nascimento, país/nacionalidade, número do documento
- Finalidade: classifica a correspondência como Falso Positivo ou Não revisado (correspondência possível)
- Limite: Limite da pontuação de correspondência (padrão: 93)
Pontuação de risco (nível de risco da entidade)
- Pergunta: qual é o risco desta entidade se for uma correspondência verdadeira?
- Fatores: risco do país, categoria (PEP/Sanções/etc.), antecedentes criminais
- Finalidade: determina o status AML final (Aprovado/Em revisão/Recusado)
- Limites: Limite de aprovação (padrão: 80) e Limite de revisão (padrão: 100)
Status de revisão das correspondências
Cada correspondência AML recebe um status de revisão com base na sua pontuação de correspondência:Dica: Você pode alterar o status de revisão de uma correspondência no Console, vendo a visão geral de AML ou clicando em uma correspondência específica para ver os detalhes.
Principais recursos
1. Extração abrangente de dados
- Extração precisa: extraia dados das informações fornecidas pelo usuário ou de documentos de identidade com tecnologia avançada de OCR.
- Lógica difusa: considere variações e erros de grafia de nomes para garantir uma captura de dados completa.
2. Ampla cobertura de listas de vigilância
Faça a triagem contra várias categorias, incluindo:- Listas de sanções: de órgãos governamentais e internacionais.
- Pessoas politicamente expostas (PEPs): indivíduos com funções públicas proeminentes.
- Antecedentes criminais: incluindo bases criminais globais e locais.
- Menções em mídia negativa: notícias e reportagens sobre crimes financeiros e outros riscos.
- Listas de vigilância personalizadas: configuráveis de acordo com os requisitos específicos de cada cliente.
3. Algoritmos de correspondência avançados
- Correspondência difusa: detecta pequenas variações em nomes ou detalhes para garantir uma correspondência precisa.
- Vários pontos de dados: use nome, data de nascimento, nacionalidade e outros identificadores para uma triagem completa.
- Lógica de chave de ouro: correspondência por número de documento, que pode se sobrepor às pontuações para uma identificação definitiva.
4. Avaliação de risco com duas pontuações
Cada correspondência recebe DUAS pontuações:
Status de revisão da correspondência (com base na pontuação de correspondência):
- Falso Positivo: pontuação de correspondência abaixo do limite - provavelmente NÃO é a mesma pessoa
- Não revisado: pontuação de correspondência igual ou acima do limite - exige revisão
- Aprovado: todas as correspondências não revisadas têm pontuações de risco baixas
- Em revisão: pelo menos uma correspondência não revisada tem pontuação de risco média a alta
- Recusado: pelo menos uma correspondência não revisada tem pontuação de risco muito alta
5. Triagem detalhada de mídia negativa
Faça a triagem contra uma ampla gama de categorias de mídia negativa, incluindo:- Crimes financeiros: lavagem de dinheiro, desvio de recursos e mais.
- Crimes violentos: agressão, homicídio e delitos relacionados.
- Terrorismo: envolvimento ou apoio a atividades terroristas.
- Narcóticos: tráfico de drogas e crimes relacionados.
- Fraude: diversos tipos de fraude e práticas enganosas.
- Violações regulatórias: descumprimento de requisitos de conformidade regulatória.
6. Parâmetros de triagem personalizáveis
- Sensibilidade ajustável: configure a sensibilidade da triagem de acordo com o apetite a risco da sua organização.
- Listas de vigilância personalizáveis: selecione quais listas e categorias incluir no processo de triagem para atender a requisitos específicos.
Limites configuráveis
Você pode personalizar os níveis de segurança definindo limites diferentes: Configuração da pontuação de correspondência:
Limites da pontuação de risco (status final):
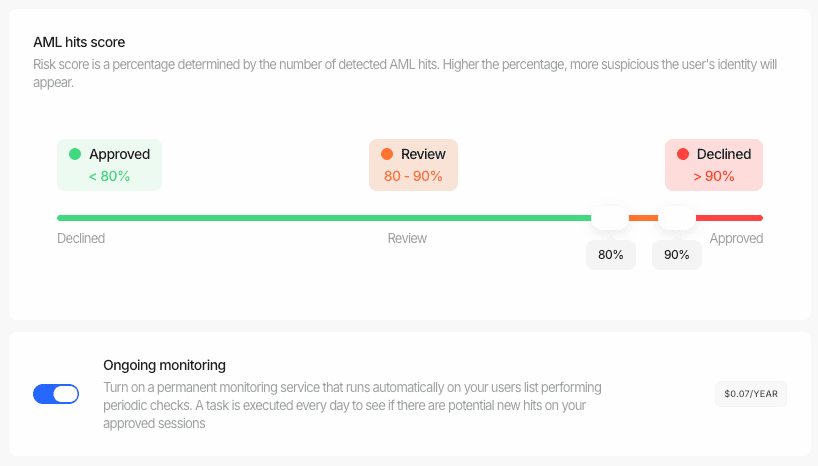
Esses limites podem ser ajustados de acordo com a sua tolerância a risco e os seus requisitos de segurança.
Como funciona
Nosso processo de Análise AML identifica riscos potenciais com eficiência e minimiza atrasos para usuários legítimos.Extração de dados
O sistema extrai as informações relevantes dos dados fornecidos pelo usuário ou dos documentos de identidade enviados.
Triagem em listas de vigilância
Os dados extraídos são cruzados em tempo real com 1,300+ listas de vigilância e bases globais:
- Listas de sanções - órgãos governamentais e internacionais (OFAC, UE, ONU etc.)
- Pessoas politicamente expostas (PEPs) - indivíduos com funções públicas proeminentes
- Antecedentes criminais - bases criminais globais e locais
- Mídia negativa - notícias e reportagens sobre crimes financeiros
- Listas de vigilância personalizadas - configuráveis de acordo com os seus requisitos
Cálculo da pontuação de correspondência
Para cada possível correspondência, o sistema calcula uma pontuação de confiança na identidade - a probabilidade de ser a mesma pessoa.
- Pontuação de correspondência abaixo do limite (padrão: 93) → classificada como Falso Positivo
- Pontuação de correspondência igual ou acima do limite → classificada como Não revisada (correspondência possível)
- Chave de ouro: a correspondência do número do documento pode elevar a pontuação para 100% para uma identificação definitiva
Cálculo da pontuação de risco
Para as correspondências que não são falsos positivos, o sistema calcula o nível de risco da entidade:
Determinação do status final
Com base na maior pontuação de risco entre todas as correspondências que não são falsos positivos:
Se todas as correspondências forem falsos positivos, o resultado é Aprovado (nenhuma correspondência relevante encontrada).
Geração do resultado
Um relatório detalhado é gerado com total transparência:
- A pontuação de correspondência e a pontuação de risco de cada correspondência, com os detalhamentos
- Classificação da correspondência (Falso Positivo vs. Não revisada vs. Confirmada)
- Base de origem e detalhes da categoria de cada resultado
- Resultados entregues por resposta da API, webhook ou Business Console
- Decisão automática com base nos limites de pontuação de risco que você configurou
Referência de dados de resultados AML
Cada resultado AML retornado na resposta da API contém informações detalhadas sobre a entidade correspondente. Abaixo estão os principais campos e seus valores possíveis.Categorias de conjuntos de dados
O campodatasets de cada resultado indica em quais categorias de bases de conformidade a entidade foi encontrada. Valores possíveis:
Correspondências de sanções
O arraysanction_matches contém os detalhes de cada lista de sanções em que a entidade foi encontrada. Principais campos:
Correspondências de avisos
O arraywarning_matches contém os detalhes das correspondências de listas de avisos, fiscalização regulatória e afins. O campo additional_data pode incluir um array data.case_details com informações estruturadas do caso.
Tipos de caso de aviso
O campocase_type dentro de additional_data.data.case_details[] descreve a natureza do caso de aviso. Valores conhecidos: