

 快速开始
 集成 / SDK
 用户验证
 企业验证
 交易监控
 更新日志
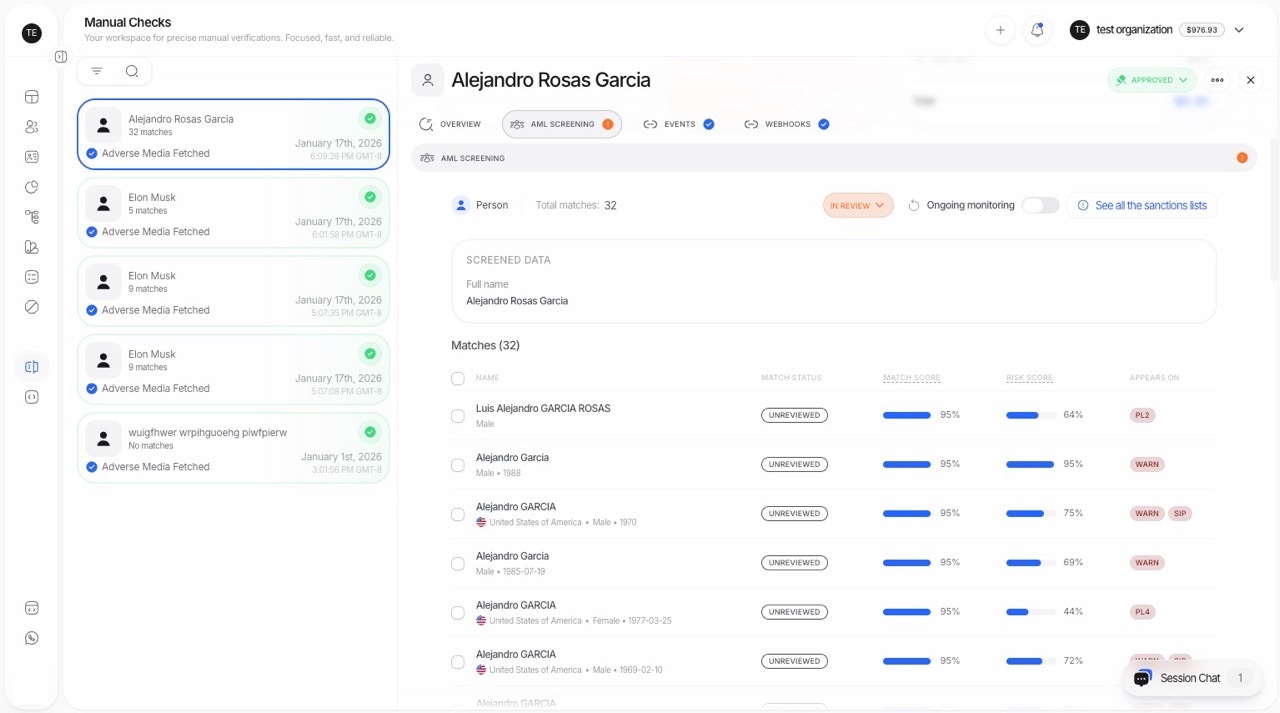
核心概念: 匹配分数与风险评分
Didit 在 AML 筛查中采用双评分体系:匹配分数 (身份置信度)
- 问题:该匹配项是否就是我们正在筛查的同一人?
- 考量因素:姓名相似度、出生日期、国家/地区/国籍、证件号码
- 用途:将匹配项归类为误报或未审核(疑似匹配)
- 阈值:匹配分数阈值(默认值:93)
风险评分 (实体风险等级)
- 问题:如果确实匹配,该实体的风险有多高?
- 考量因素:国家/地区风险、类别(PEP/制裁等)、犯罪记录
- 用途:决定最终 AML 状态(已通过/审核中/已拒绝)
- 阈值:通过阈值(默认值:80)与审核阈值(默认值:100)
匹配审核状态
系统会根据每个 AML 匹配项的匹配分数为其分配审核状态:提示: 您可以在控制台中通过查看 AML 概览或点击特定匹配项查看其详情来更改匹配审核状态。
主要功能
1. 全面的数据提取
- 精准提取:使用先进的 OCR 技术从用户提供的信息或身份证件中提取数据。
- 模糊逻辑:兼顾姓名变体和拼写错误,确保数据采集全面完整。
2. 广泛的观察名单覆盖
针对多个类别进行筛查,包括:- 制裁名单:来自政府和国际机构。
- 政治公众人物(PEP):担任重要公众职务的个人。
- 犯罪记录:包括全球和本地犯罪数据库。
- 负面新闻:涉及金融犯罪及其他风险的新闻文章和报告。
- 自定义观察名单:可根据特定客户需求进行配置。
3. 先进的匹配算法
- 模糊匹配:捕捉姓名或详细信息的细微差异,确保精准匹配。
- 多数据点:利用姓名、出生日期、国籍及其他标识符进行全面筛查。
- 黄金密钥(Golden Key)逻辑:证件号码匹配可覆盖评分,用于明确确认身份。
4. 双评分风险评估
每个匹配项都会获得两个评分:
匹配审核状态(基于匹配分数):
- 误报:匹配分数低于阈值 - 可能不是同一人
- 未审核:匹配分数达到或高于阈值 - 需要审核
- 已通过:所有未审核匹配项的风险评分均较低
- 审核中:至少有一个未审核匹配项具有中高风险评分
- 已拒绝:至少有一个未审核匹配项具有极高风险评分
5. 详细的负面新闻筛查
针对广泛的负面新闻类别进行筛查,包括:- 金融犯罪:洗钱、挪用公款等。
- 暴力犯罪:袭击、谋杀及相关罪行。
- 恐怖主义:参与或支持恐怖活动。
- 毒品:贩毒及相关犯罪。
- 欺诈:各类欺诈和欺骗行为。
- 违规行为:违反监管合规要求。
6. 可自定义的筛查参数
- 灵敏度可调:根据您组织的风险偏好配置筛查灵敏度。
- 可自定义观察名单:选择筛查流程中包含的观察名单和类别,以满足特定要求。
可配置阈值
您可以通过设置不同的阈值来自定义安全级别: 匹配分数配置:
风险评分阈值(最终状态):
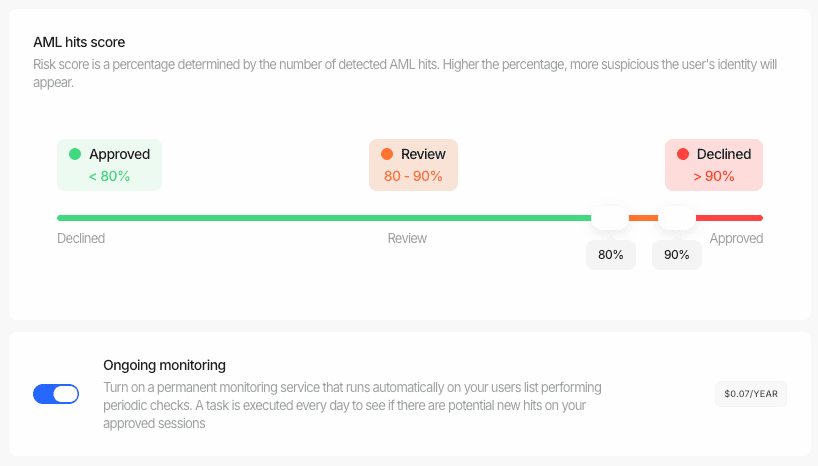
这些阈值可以根据您的风险承受能力和安全要求进行调整。
工作原理
我们的 AML 筛查流程能够高效识别潜在风险,同时最大限度减少合法用户的等待时间。数据提取
系统从用户提供的数据或上传的身份证件中提取相关信息。
观察名单筛查
提取的数据将与 1,300+ 个全球观察名单和数据库进行实时交叉比对:
- 制裁名单 — 政府和国际机构(OFAC、欧盟、联合国等)
- 政治公众人物 (PEP) — 担任重要公共职务的人员
- 犯罪记录 — 全球和本地犯罪数据库
- 负面新闻 — 关于金融犯罪的新闻报道和文章
- 自定义观察名单 — 可根据您的需求进行配置
匹配分数计算
对于每个潜在匹配项,系统会计算一个身份置信度分数 — 即其为同一人的可能性。
- 匹配分数低于阈值(默认值:93)→ 归类为误报
- 匹配分数达到或高于阈值 → 归类为未审核(疑似匹配)
- 黄金密钥:证件号码匹配可将匹配分数覆盖为 100%,以实现明确识别
风险评分计算
对于非误报的匹配项,系统会计算该实体的风险等级:
最终状态判定
基于所有非误报匹配项中的最高风险评分:
如果全部匹配项均为误报,则结果为已通过(未发现可靠的匹配项)。
生成结果
生成透明详尽的报告:
- 每个匹配项的匹配分数和风险评分及其细分明细
- 匹配分类(误报 vs. 未审核 vs. 已确认)
- 每个命中的来源数据库和类别详情
- 结果通过 API 响应、Webhook 或 Business Console 交付
- 根据您配置的风险评分阈值进行自动决策
AML 命中数据参考
API 响应中返回的每个 AML 命中项均包含有关匹配实体的详细信息。以下是关键字段及其可能的值。数据集类别
每个命中项上的datasets 字段指明了该实体匹配到的合规数据库类别。可能的值:
制裁匹配
sanction_matches 数组包含该实体被列入的各个制裁名单的详细信息。关键字段:
警告匹配
warning_matches 数组包含来自警告、监管执法及相关名单的匹配详情。additional_data 字段可能包含一个带有结构化案件信息的 data.case_details 数组。
警告案件类型
additional_data.data.case_details[] 内的 case_type 字段描述了警告案件的性质。已知的值: