

 快速开始
 集成 / SDK
 用户验证
 企业验证
 交易监控
 更新日志
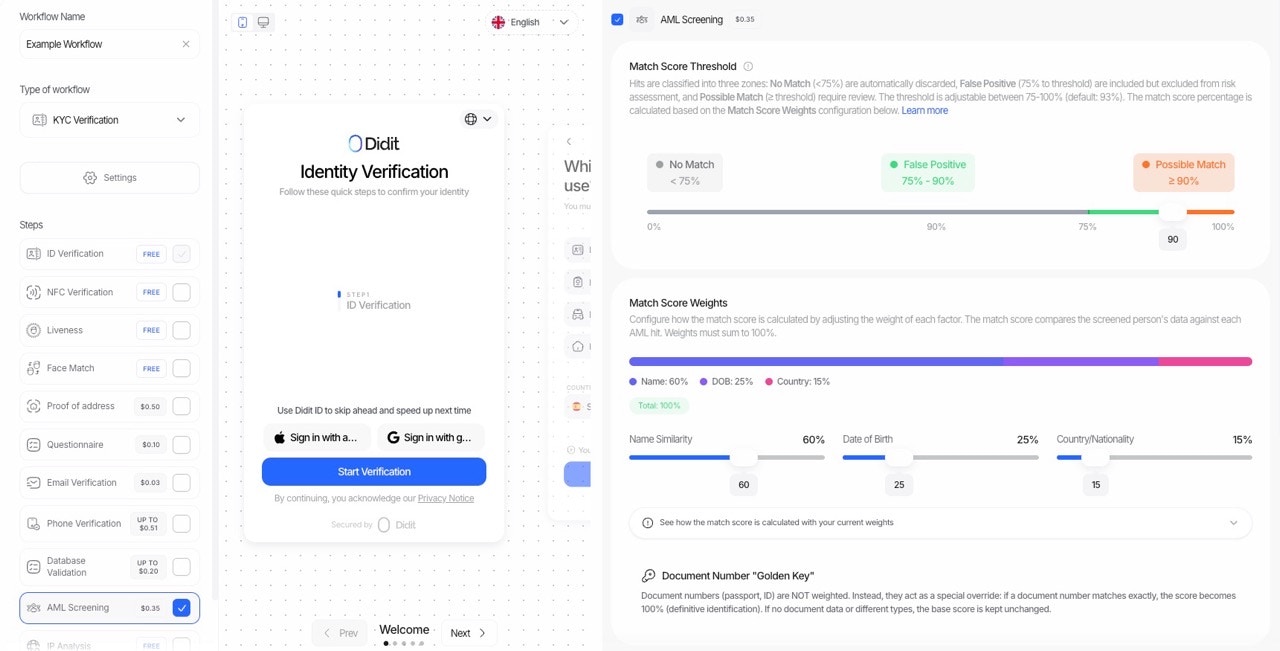
⚠️ 重要提示:匹配分数决定的是单个匹配项的分类,而不是最终的 AML 状态。最终的 AML 状态(已通过/审核中/已拒绝)由非误报匹配项的风险评分决定。
概述
在针对 AML 观察名单筛查人员时,每个潜在匹配项都会获得一个 0-100 的匹配分数。该分数回答了这样一个问题:“该匹配项实际上是不是我们正在筛查的同一个人?”匹配分数与风险评分
匹配分数如何确定审核状态
每个匹配项都根据其匹配分数进行分类:默认阈值:93%示例:阈值为 93 时:
- 分数为 85 的匹配项 → 误报(自动忽略)
- 分数为 95 的匹配项 → 未审核(需要审核,风险评分决定紧迫性)
审核状态详解
所有 AML 匹配项都会根据其匹配分数获得以下两种初始状态之一:
人工审核后,合规官可以将状态更新为:
提示: 您可以在控制台中通过查看 AML 概览或点击特定匹配项查看其详情来更改匹配项的审核状态。
匹配分数的计算方式
步骤 1: 基础分数计算
基础分数使用三个具有可配置权重的组件进行计算:注意:权重之和必须始终为 100%。
步骤 2: 证件号码“金钥匙”逻辑
计算出基础分数后,将使用特殊的覆盖逻辑单独评估证件号码:
这种方法认识到匹配的证件号码是身份的决定性证明(“金钥匙”),而证件类型不匹配则不应扣减分数。
评分构成要素详情
姓名相似度(0-100)
姓名匹配使用来自 RapidFuzz 的 WRatio 算法,该算法能够较好地应对以下情况:- 打字错误与拼写错误
- 词序差异(“John Smith” 对比 “Smith, John”)
- 中间名变体(“Robert J. Smith” 对比 “Robert James Smith”)
- 长度差异
出生日期评分
重要说明: 当匹配项仅提供年份(例如 “1974”)时,与该年份匹配将计为完全匹配,因为可供核验的信息仅此而已。
国家/地区/国籍评分
系统会自动在以下格式之间进行转换:
- ISO alpha-2 代码(ES)
- ISO alpha-3 代码(ESP)
- 完整的国家/地区名称(Spain)
countries 之外,系统还会检查 citizenship 字段。
分数归一化(重新分配权重)
当被筛查人员或匹配项缺少数据时,系统会使用分数归一化来避免因信息缺失而对其进行扣分。示例:仅限姓名筛查
如果您仅使用姓名进行筛查(无出生日期或国家/地区):
结果: 姓名得分即构成整个匹配分数。
示例:匹配项缺少国家/地区数据
如果匹配项没有国家/地区数据但有出生日期:
这确保了无论数据完整程度如何,评分都保持公平。
配置选项
您可以通过 API 或工作流设置自定义匹配分数的计算方式:匹配分数阈值
权重(总和必须为 100)
API 请求示例
响应:分数明细
响应中的每个匹配项均包含:match_score— 计算出的匹配分数(0-100)risk_score— 计算出的风险评分(0-100)- 参见 风险评分review_status— 基于匹配分数阈值判定为 “False Positive” 或 “Unreviewed”score_breakdown— 匹配分数计算的详细明细
完整流程:从匹配分数到最终 AML 状态
计算示例
示例 1: 强匹配 → 未审核
筛查数据:- 姓名:“Robert J. Smith”
- 出生日期:“1985-03-15”
- 国家/地区:“US”
- 姓名:“Robert James Smith”
- 出生日期:“1985”
- 国家/地区:“United States”
- 姓名得分:90%(模糊匹配)
- 出生日期得分:100%(匹配项仅有年份,且年份匹配)
- 国家/地区得分:100%(完全匹配)
示例 2: 弱匹配 → 误报
筛查数据:- 姓名:“John Smith”
- 出生日期:“1990-05-20”
- 国家/地区:“US”
- 姓名:“Johnny Smithson”
- 出生日期:“1975”
- 国家/地区:“Canada”
- 姓名得分:72%(弱模糊匹配)
- 出生日期得分:-100%(年份不匹配惩罚)
- 国家/地区得分:-50%(国家/地区不匹配惩罚)
示例 3: Golden Key 覆盖
筛查数据:- 姓名:“John D. Smith”
- 证件号码:“A12345678”
- 姓名:“Jonathan David Smith”
- 证件号码:“A12345678”
- 基础得分:约 70(姓名模糊匹配)
- 证件号码:匹配(完全匹配)
管理审核状态
初始分类完成后,您可以手动更新每个匹配项的审核状态:在控制台中
- 前往会话的 AML 概览页面
- 点击特定匹配项以查看详情
- 使用状态下拉菜单更改审核状态:
- 已确认匹配 — 确认匹配项为同一人
- 误报 — 将匹配项标记为不匹配
- 无法定论 — 无法确定
最佳实践
- 从默认阈值 (93) 开始 — 这在捕获真实匹配与过滤误报之间提供了良好的平衡。
- 针对高风险场景降低阈值 — 如果您需要更加谨慎,请降低匹配分数阈值以捕获更多潜在匹配。
- 有证件号码时使用证件号码 — 它们能提供最强有力的身份确认,并可以覆盖较低的匹配分数。
- 查看归一化权重 — 检查分数明细中的归一化权重字段,以了解缺失数据如何影响最终得分。
- 监控误报率 — 如果有过多合理匹配项被标记为误报,请调低阈值。