

 快速开始
 集成 / SDK
 用户验证
 企业验证
 交易监控
 更新日志
概述
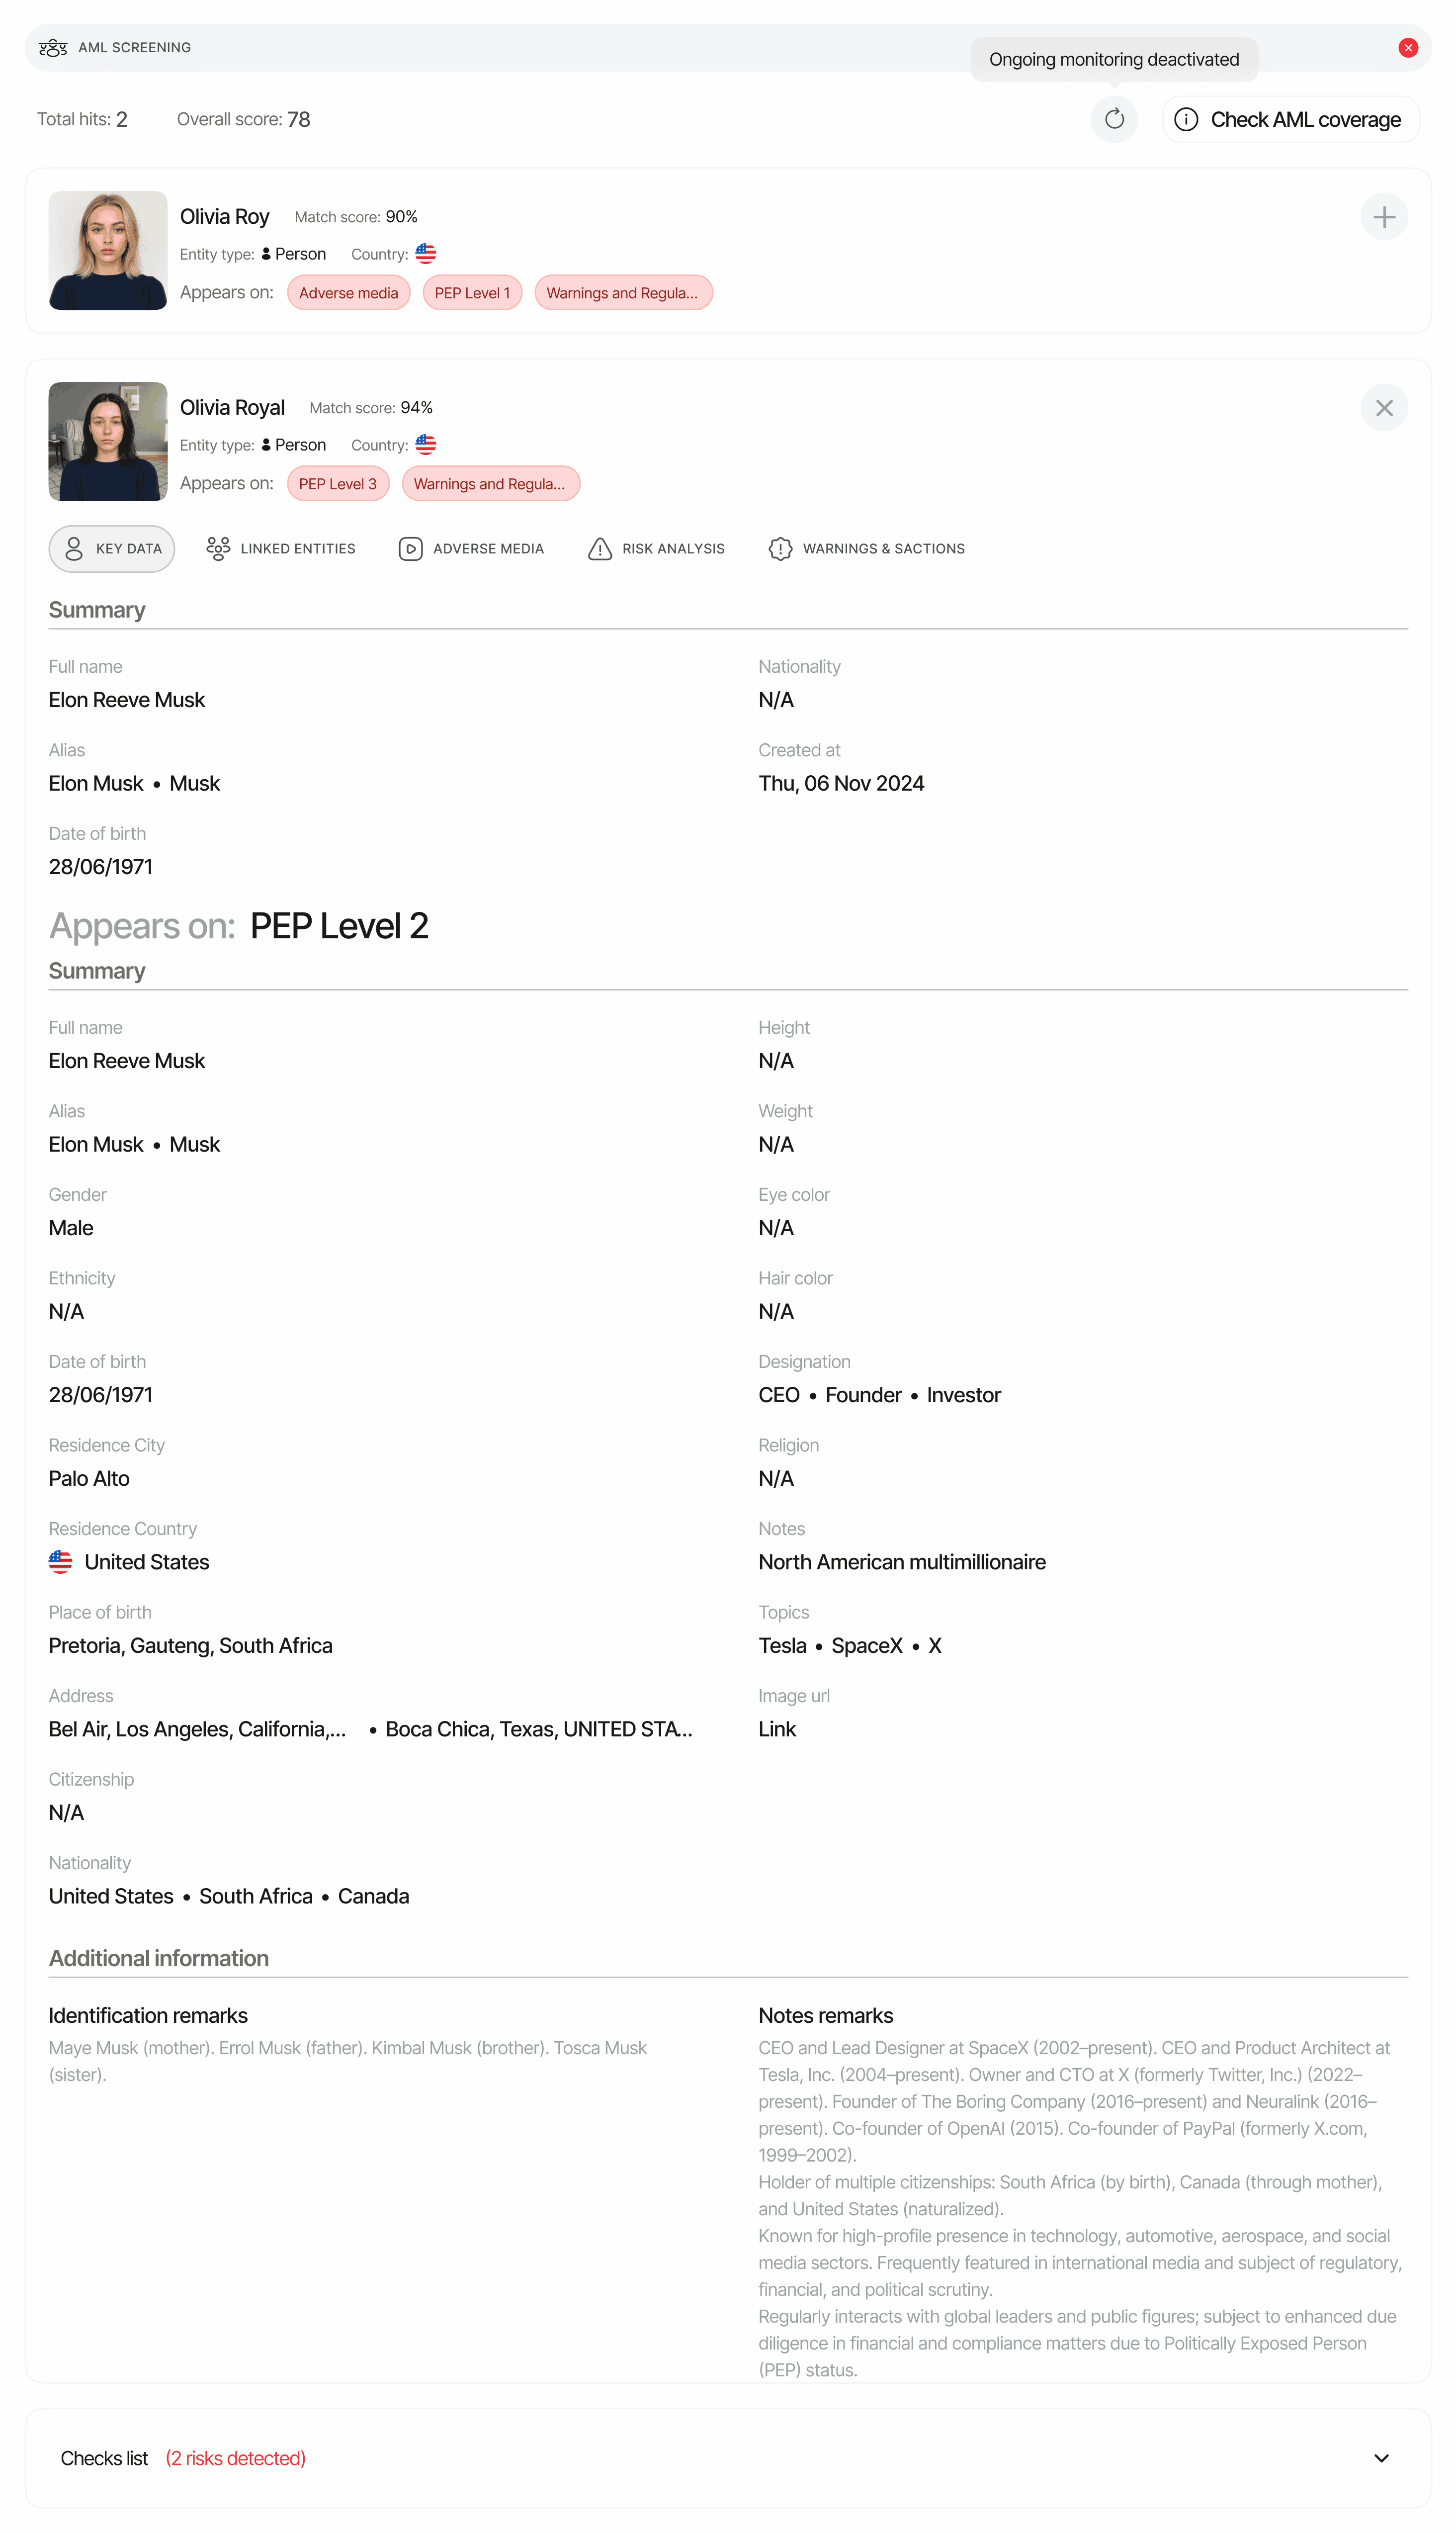
AML 筛查将已验证主体的身份与全球制裁、PEP、观察名单和负面新闻数据集进行交叉比对。每一次命中都会返回匹配到的实体、产生匹配的数据集、两项评分:match_score(身份置信度)和 risk_score(实体风险),以及按来源划分的结构化明细(pep_matches[]、sanction_matches[]、warning_matches[]、adverse_media_matches[])。综合 score 是未标记为 False Positive 的命中项中的最高 risk_score。
用户(KYC)会话、企业(KYB)会话以及独立 AML API 上的 AML 筛查均返回相同的结构。
在 API 响应中的位置
在会话决策 endpoint 上,AML 筛查以复数数组aml_screenings[] 的形式返回。每个条目对应工作流中的一次 AML 执行(运行两次的 AML 检查将生成具有不同 node_id 值的两个条目)。
三项评分而非单一结论
status 是一项结论;推导该结论所依据的数值包含在同一个 payload 中。当您构建自己的风险分级(例如将 AML 风险与财富来源或 PEP 自我声明等问卷答案相结合)时,请读取这些数值,而不是仅根据 Approved / In Review / Declined 进行分支判断:
这三项数值存在于交付 AML 报告的每一个位置:
GET /v3/session/{sessionId}/decision/、所有 Webhook 版本(V3 aml_screenings[] 以及旧版 V2 / V1 单数形式 aml)中 status.updated 和 data.updated Webhook 的 decision 对象,以及独立 AML API。仅看到标记/清除标签的调用方只是读取了 status(或命中项的 review_status),而忽略了其旁边的评分。控制台显示相同的数值:AML 区域标题显示综合风险评分,匹配项表格的每一行都显示匹配分数和风险评分,并在悬停时提供明细。
架构
有关规范的架构,请参阅数据模型参考中的 AML 筛查。顶层字段:各匹配项字段
hits[] 中的每个条目都包含以下字段(仅展示部分字段)。匹配来源数组 — pep_matches[]、sanction_matches[]、warning_matches[]、adverse_media_matches[] — 仅针对该匹配项所属的数据集进行填充。
被归类为
False Positive 的匹配项(因 match_score 低于匹配分数阈值,或由审核员标记)仍会保留在 hits[] 中以供审计。它们仅在计算综合 score 时被排除。持续监控
当is_ongoing_monitoring_enabled 为 true 时,Didit 会持续对该主体重新筛查,并在任何命中记录增加、移除或发生变化时再次发出 AML 报告。改变 AML 状态的重新筛查会触发 status.updated Webhook;仅改变命中数据的重新筛查则触发 data.updated。监控周期从 last_aml_bill_date 起持续 365 天;next_ongoing_monitoring_bill_date 会显示下一次年度续费的计费时间。
这些信号均由变更驱动,因此如果某主体被重新筛查数月且无新增命中,则不会产生上述任何信号。last_ongoing_screening_at 是在每一次筛查运行完成时都会更新的唯一字段,并且 筛查历史 endpoint 会逐一列出每次运行 — 包括未产生任何变更的运行。有关完整生命周期,请参阅持续 AML 监控。
状态值
阈值可针对每个工作流节点单独配置 — 请参阅 AML 风险评分。自定义状态规则与推导出的状态合并,优先级顺序为
Declined > In Review > Approved;审核员也可以通过控制台或 AML 状态 endpoint 覆盖 AML 状态。